はじめに
本記事では、Optuna v5 および Rustuna でハイパーパラメータ重要度推定手法のデフォルトとなった PedAnovaImportanceEvaluator について紹介します。
ハイパーパラメータ重要度 (Hyperparameter Importance: HPI) は、観測された目的関数値に対して各ハイパーパラメータがどの程度影響を与えるかを定量化する指標であり、ハイパーパラメータ最適化において重要な役割を果たします。HPI は、最適化結果の解釈、重要な設計上の選択肢の特定、影響の小さいハイパーパラメータや冗長なハイパーパラメータの検出、さらには後続の探索や手動でのチューニングの方針決定に役立ちます。
これまで Optuna では f-ANOVA [2] をデフォルトの HPI 推定手法として使用していましたが、Optuna v5 では、以下のような様々な利点を持つことから PED-ANOVA [4] を新たなデフォルトとして採用しました:
- f-ANOVA と比較して圧倒的に高速に計算できる
- Optuna で標準の最小限の依存関係のみで利用できる
- 条件付き探索空間や多目的最適化に対応できる
特に、条件付き探索空間への対応は今回我々が新たに開発した手法であり、機械学習分野のトップ国際会議の 1 つである KDD 2026 に採択されました。詳しくは、以下の論文 [1] をご参照ください:
Optuna & Rustuna での PED-ANOVA の使い方
基本的な使い方
PED-ANOVA は Optuna または Rustuna で追加のインストールなしに使用可能です:
# Using Optuna:
uv add "optuna>=5.0.0"
# Using Rustuna:
uv add "rustuna>=0.1.0"
# If you use pip:
pip install "optuna>=5.0.0"
# or
pip install "rustuna>=0.1.0"
インストールが完了したら、完了済み trial を含む study を optuna.importance.get_param_importances に渡すだけで簡単に利用できます:
import optuna
# If you use Rustuna:
# import rustuna as optuna
def objective(trial: optuna.Trial) -> float:
   x = trial.suggest_float("x", -5.0, 5.0)
   y = trial.suggest_float("y", -1.0, 1.0)
   return x**2 + y**2
sampler = optuna.samplers.RandomSampler(seed=42)
study = optuna.create_study(sampler=sampler, direction="minimize")
study.optimize(objective, n_trials=100)
importance = optuna.importance.get_param_importances(study) # Use PedAnovaImportanceEvaluator as default
print(importance) # {'x': 0.9773158726469768, 'y': 0.022684127353023158}
Optuna を使用している場合は、以下のようにして重要度を可視化することもできます。なお、可視化には Plotly または Matplotlib を別途インストールする必要があります。
# Use Plotly
fig = optuna.visualization.plot_param_importances(study)
fig.show()
# Use Matplotlib
import matplotlib.pyplot as plt
ax = optuna.visualization.matplotlib.plot_param_importances(study)
plt.show()
重要度の解釈
HPI は、各ハイパーパラメータが目的関数値の分散にどの程度寄与するかに基づいて定義されます。PedAnovaImportanceEvaluator では、target_quantile と region_quantile という2つの主要な引数を用いて、特定の性能領域における重要度を推定します。得られる重要度は、観測された性能の上位 region_quantile の領域に着目したとき、それより狭い上位 target_quantile の性能を達成するために各ハイパーパラメータがどの程度重要であるかを表します。
evaluator = optuna.importance.PedAnovaImportanceEvaluator(target_quantile=0.1, region_quantile=1.0) # The default settings
importance = optuna.importance.get_param_importances(study, evaluator=evaluator)
print(importance)
実験結果
本節では、実際のベンチマーク問題を用いた実験結果を通して、PED-ANOVA がどのように振る舞うかを紹介します。条件付き探索空間に対する PED-ANOVA の詳細な実験的分析や、既存手法との性能比較については、我々の論文 [1] をご参照ください。
実験設定
ベンチマーク問題。 YAHPO Gym [3] の rbv2_super シナリオにおけるインスタンス 1053 を使用します。このベンチマークは、近似 k-NN (aknn) 、正則化線形モデル (glmnet) 、ランダムフォレスト (ranger)、決定木 (rpart)、サポートベクターマシン (svm)、XGBoost (xgboost) の6種類の機械学習アルゴリズムから、適切なモデルを選択する問題です。カテゴリカルなハイパーパラメータ learner_id によってアルゴリズムを選択し、選択されたアルゴリズムに対応するハイパーパラメータのみが有効になります。そのため、この問題は条件付き探索空間を含みます。
評価設定。 サンプルサイズを 𝑁 = 1000 とし、正解率 (acc) の最大化を目的とします。PED-ANOVA の設定は、target_quantile = 0.1、region_quantile = 1.0 とします。実行環境には Python 3.13.11 およびOptuna v5.0.0 を使用します。実験用コードについては、我々のGitHubリポジトリをご参照ください。
結果と考察
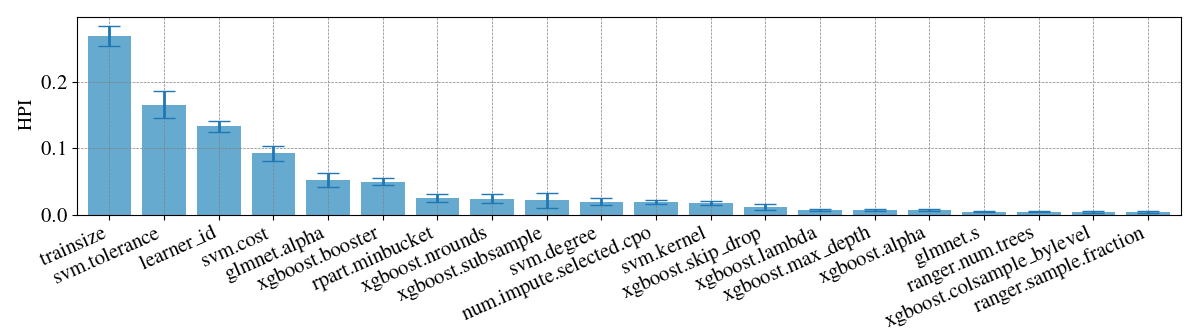
図1 に PED-ANOVA によって推定された HPI を示します。trainsize や learner_id、さらに SVM や XGBoost に関連するいくつかのハイパーパラメータが、比較的高い重要度を示していることがわかります。実際の目的関数値においても、SVM と XGBoost は他のアルゴリズムより高い性能を達成しており、PED-ANOVA がアルゴリズムの選択に関する重要度を適切に捉えていることが示唆されます。
さらに、各アルゴリズムが達成した目的関数値の最大値と、推定された重要度との相関を計算しました。その結果、PED-ANOVA は、既存の HPI 推定手法を単純に条件付き探索空間へ拡張したベースライン手法と比較して、最も高い相関を示しました。また、これらのベースライン手法とは異なり、負の相関が生じるような不安定な挙動も見られませんでした。詳細については、我々の論文をご参照ください。
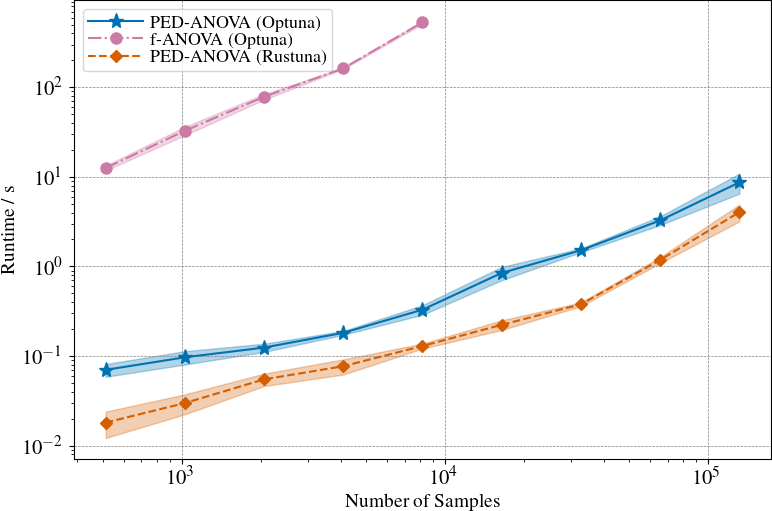
実行時間の比較。 図2 では、同じ YAHPO Gym のベンチマーク問題に対して、Optuna v5 の PED-ANOVA、Rustuna の PED-ANOVA、および Optuna で従来のデフォルトとして使用されていた f-ANOVA の実行時間を比較しています。Optuna の PED-ANOVA は f-ANOVA と比較して圧倒的に高速であり、実験した試行数の範囲で約180~1,600倍の高速化を達成しています。さらに、Rustuna の PED-ANOVA は、Optuna の実装と比較して約2~4倍高速に動作します。
おわりに
本記事では、Optuna v5 および Rustuna でデフォルトの HPI 評価手法となった PED-ANOVA を紹介しました。PED-ANOVA は、条件付き探索空間や多目的最適化に対応しつつ、高速かつ実用的な HPI 評価を可能にします。
ぜひお試しください!
お知らせ
Optuna の Meetup イベントを 10/16 (金) に都内で開催します。先日公開された Optuna 5.0 の最新機能や Rustuna の紹介のほか、Optuna の作者である秋葉拓哉氏による講演を予定しております。皆さまのご参加をお待ちしております!
参加登録はこちら:https://optuna.connpass.com/event/406648/
参考文献
- Baba, K., Ozaki, Y., and Watanabe, S. Conditional PED-ANOVA: Hyperparameter importance in hierarchical & dynamic search spaces. In Proceedings of the 32nd ACM SIGKDD Conference on Knowledge Discovery and Data Mining V.2, pp. 57–68. Association for Computing Machinery, 2026. ISBN 9798400722592. doi: 10.1145/3770855.3817758.
- Hutter, F., Hoos, H., and Leyton-Brown, K. An efficient approach for assessing hyperparameter importance. In Proceedings of the 31st International Conference on Machine Learning, pp. 754–762. PMLR, 2014.
- Pfisterer, F., Schneider, L., Moosbauer, J., Binder, M., and Bischl, B. YAHPO Gym - an efficient multi-objective multi-fidelity benchmark for hyperparameter optimization. In Proceedings of the First International Conference on Automated Machine Learning, volume 188, pp. 3/1–39. PMLR, 2022.
- Watanabe, S., Bansal, A., and Hutter, F. PED-ANOVA: Efficiently quantifying hyperparameter importance in arbitrary subspaces. In Proceedings of the 32nd International Joint Conference on Artificial Intelligence, pp. 4389–4396, 2023.