概要
- 翻訳特化LLM plamo-3-translateを開発し、PLaMo翻訳 [1] で提供を開始しました。
- plamo-3-translateでは、plamo-2-translate比で数百倍の学習トークン量 / データ合成の計算量を投じて、劇的な性能向上を実現しました。
- plamo-3-translateは日英翻訳・多言語翻訳の双方で世界最高クラスの性能を、既存の翻訳・LLM APIの数十分の一のコストで達成しました。特に文脈に沿った自然な翻訳文を書き上げる能力に優れています。
原文 | モデル | 訳文 |
I realize this adds another step for you. Could you send me the revised quote? If you just sent it, apologies if our emails crossed. | plamo-3-translate 31B | お手数をおかけして恐縮ですが、修正後の見積書をお送りいただけますでしょうか。もし既にお送りいただいている場合は、メールが行き違いになってしまい申し訳ございません。 |
他社翻訳サービス | これで、お手数をおかけすることになるのは承知しています。修正後の見積書を送っていただけますか?もし先ほど送っていただいたばかりであれば、メールのやり取りが重なってしまったようで申し訳ありません。 |
開発の背景
Preferred Networks (以下PFN) では自社で国産LLM PLaMo [2] をフルスクラッチ開発しています。
2025年には、PLaMo第2世代をベースに翻訳能力を高める学習を行った翻訳特化LLM plamo-2-translate [3] を開発、リリースしました。Hugging Faceにモデル重みが公開されており、どなたでもローカルでお試しいただけます。
このモデルを背景に、ブラウザ翻訳、ファイル翻訳、英文添削、ライブ音声翻訳、デスクトップアプリなどを備えた総合翻訳SaaSとしてPLaMo翻訳をリリースしています。直近では、会議翻訳機能を新規にリリースしました。期間限定の無料トライアルとしてお申し込みいただければどなたでもお試しいただけます。
翻訳特化LLMを開発するのみならず、それを用いたプロダクトをリリースしたことで、SaaSの開発・運用およびユーザヒアリングを通して、様々な課題が見えてきました。特に代表的な課題としては以下のようなものがあります。
- 全体的な翻訳品質。plamo-2-translateはベースモデルの能力もあり非常に流暢な日本語を生成できますが、やや意訳が多く、稀に情報の付け足しや欠落が見られました。
- 多言語能力。plamo-2-translateは主に日英・英日に特化した翻訳モデルであり、多言語能力に関しては際立って高いとは言えませんでした。
これらの課題意識から、PFNではPLaMo第3世代 (*1) をベースに、これまでより遥かに大規模に翻訳能力を高める学習を行った翻訳特化LLM plamo-3-translateを開発しました。このモデルは本日よりPLaMo翻訳で用いられており、どなたでも今すぐお試しいただけます。
本Tech Blogでは、plamo-3-translateのベンチマーク結果と、PLaMo翻訳SaaSがもたらす体験についてご紹介します。
なお、plamo-3-translateの開発は現在も進行中であり、更に性能を高めるための施策を検討中です。完成次第、plamo-2-translateと同様にHugging Faceにモデルをアップロードし、開発の技術的な中身についてのTech Blogを公開予定です。そちらについては、今しばらくお待ちいただければと思います。
plamo-2-translateからの性能向上
plamo-3-translate 8Bの性能を、同じく8Bモデルであるplamo-2-translateと比較します。参考として、Googleの翻訳特化LLMである TranslateGemma 27B [4] も掲載しています。これは3倍以上大きな翻訳特化LLMです。
モデル | PFTB 英 → 日 | PFTB 日 → 英 | SaaS 英 → 日 | WMT24++ 英 → 日 COMET-22 | FLORES+ 日 → 多言語 chrF++ | FLORES+ 多言語 → 日 chrF++ |
plamo-2-translate (8B) | 0.447 | 0.602 | 0.430 | 0.882 | 39.28 | 29.90 |
plamo-3-translate 8B | 0.547 | 0.672 | 0.571 | 0.879 | 43.40 | 31.04 |
| TranslateGemma 27B | 0.438 | 0.634 | 0.395 | 0.882 | 42.17 | 28.18 |
日英・英日の性能計測には次のベンチマークを用いています。
- WMT24++ [5]
- WMT24(Ninth Conference on Machine Translation)で用いられた評価データを基に、英語から55の言語・方言への翻訳を評価できるよう拡張したベンチマークです。今回は日本語トラックを対象とし、性能計測指標として COMET-22 [6] を用いています。
- PFTBベンチマーク
- 社内で開発した、幅広い分野の日英・英日翻訳の性能を計測するベンチマークです。評価手法については [7] もご参照ください。参照訳との間のn-gramベースの指標により性能を計測します。
- SaaSベンチマーク
- 社内で開発した、PLaMo翻訳SaaSの体験と直結するよう、実際のリクエストに近いフォーマットでの性能を計測するベンチマークです。参照訳との間のn-gramベースの指標により性能を計測します。
多言語の性能計測には次のベンチマークを用いています。
FLORES+ [8]
- 次の言語について、「日本語 → 多言語」「多言語 → 日本語」の双方向の性能の平均値を算出しています。
アラビア語、イタリア語、インドネシア語、英語、オランダ語、韓国語、スペイン語、タイ語、中国語(簡)・中国語(繁)、ドイツ語、フランス語、ベトナム語、ロシア語
- なお、一旦上記の言語のみで性能を計測していますが、plamo-3-translate自体は追加で以下の言語についても学習を実施しています。また、日本語と他の言語の間だけではなく、多言語同士の翻訳の学習も一定程度実施しています。
ハンガリー語・ポーランド語・ヒンディー語・ペルシア語・ベンガル語・タガログ語・ヘブライ語・タミル語・ビルマ語・ウルドゥー語・マレー語・ネパール語・カタルーニャ語・マラヤーラム語・ブルガリア語・セルビア語・クロアチア語・スロバキア語・スロベニア語・シンハラ語・アゼルバイジャン語・ジョージア語・アルメニア語・ウズベク語・リトアニア語・クメール語・ラトビア語・エストニア語・バスク語・セブアノ語・ベラルーシ語・テルグ語・ジャワ語・カザフ語・マラーティー語・スワヒリ語・グジャラート語・パンジャブ語
- 性能計測指標としてchrF++ [9] を用いています。
- 「多言語 → 日本語」の性能計測においては、常体/敬体のブレによってスコアが大きく変わるのを避けるため、これらを指定可能なAPI/モデルについては敬体で翻訳するように明示しています。
WMT24++は性能が飽和しており、どのモデルの性能もほとんど差がありませんが、PFTBやSaaSベンチマークを見ると、plamo-3-translateはplamo-2-translateから劇的に性能を向上できていることがうかがえます。
plamo-2-translateは日英・英日翻訳を主眼として開発したモデルでしたが、多言語→日本語の翻訳においては、学習対象外の言語であるにもかかわらず、すでにTranslateGemma 27Bに比肩する性能を持っていました。plamo-3-translateでは多言語の対訳データを本格的に学習に取り入れたことで、特に日本語→多言語では、plamo-2-translateから大幅な性能向上が見られます。
総合して、plamo-3-translateは、参考として掲載した3倍以上大きなモデルであるTranslateGemma 27Bをも大きく上回る性能を達成しています。
フロンティアとの比較
plamo-2-translateでは8Bモデルのみを開発していましたが、今回開発中のplamo-3-translateでは、最大サイズのモデルとしてplamo-3-translate 31Bを開発しました。
plamo-3-translate 31Bのベンチマーク結果を以下に示します。
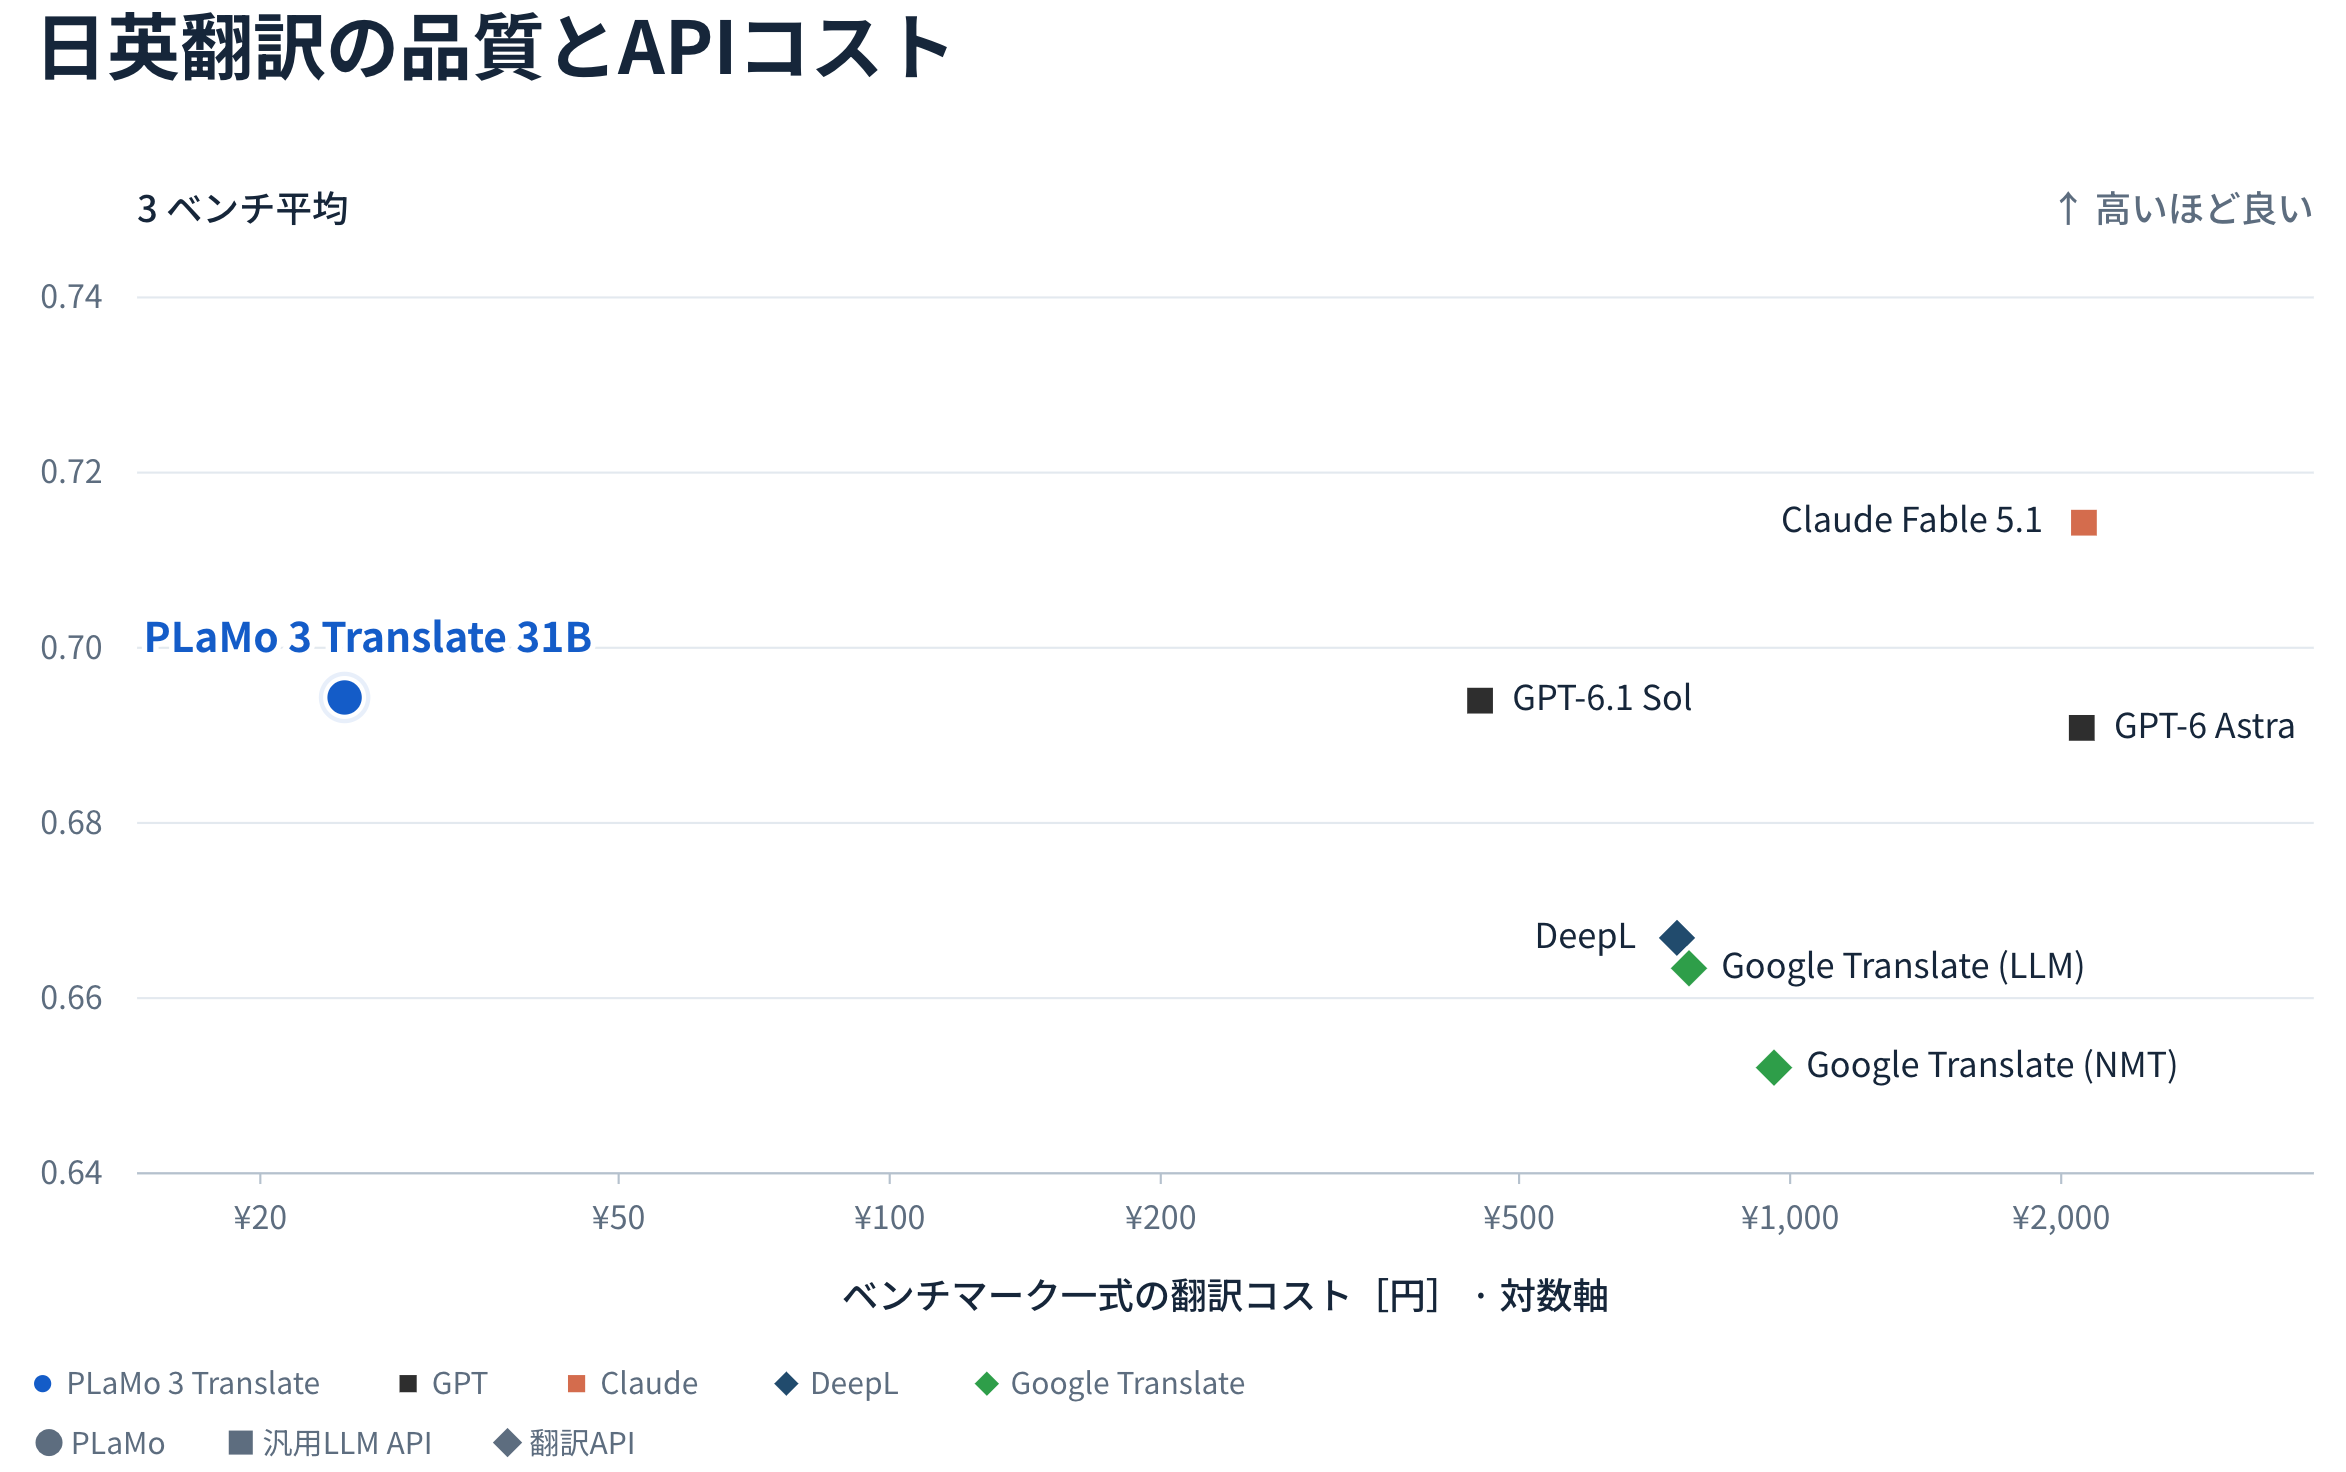
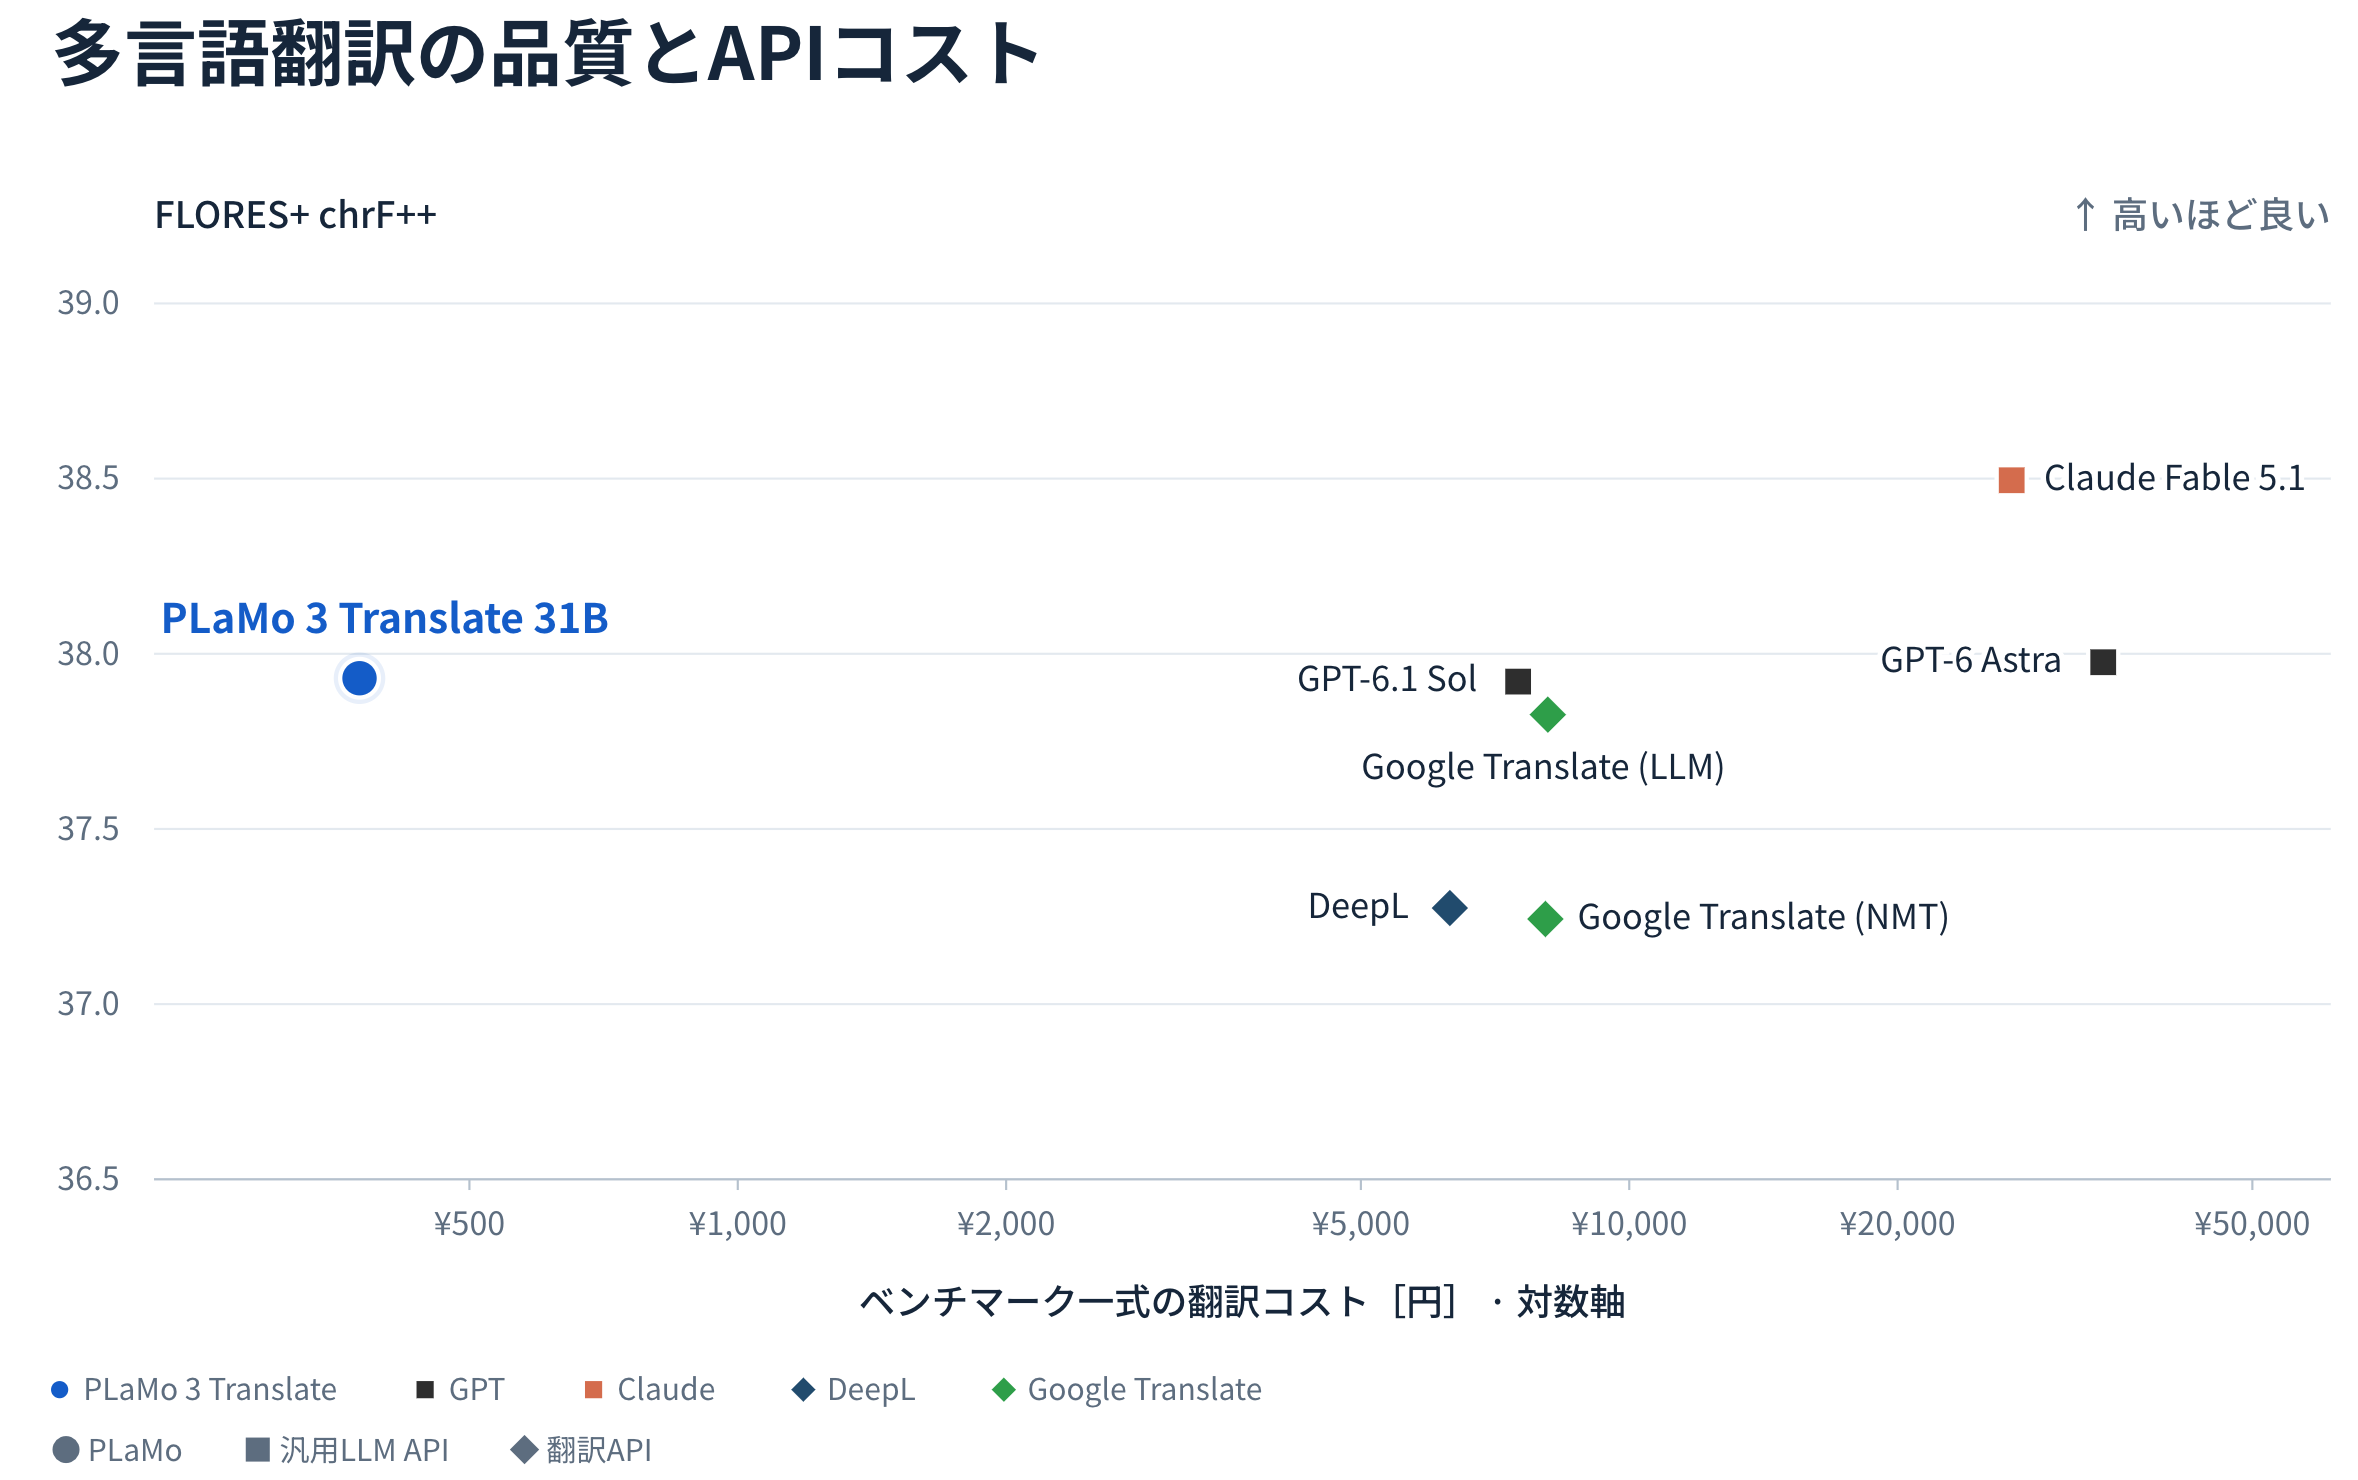
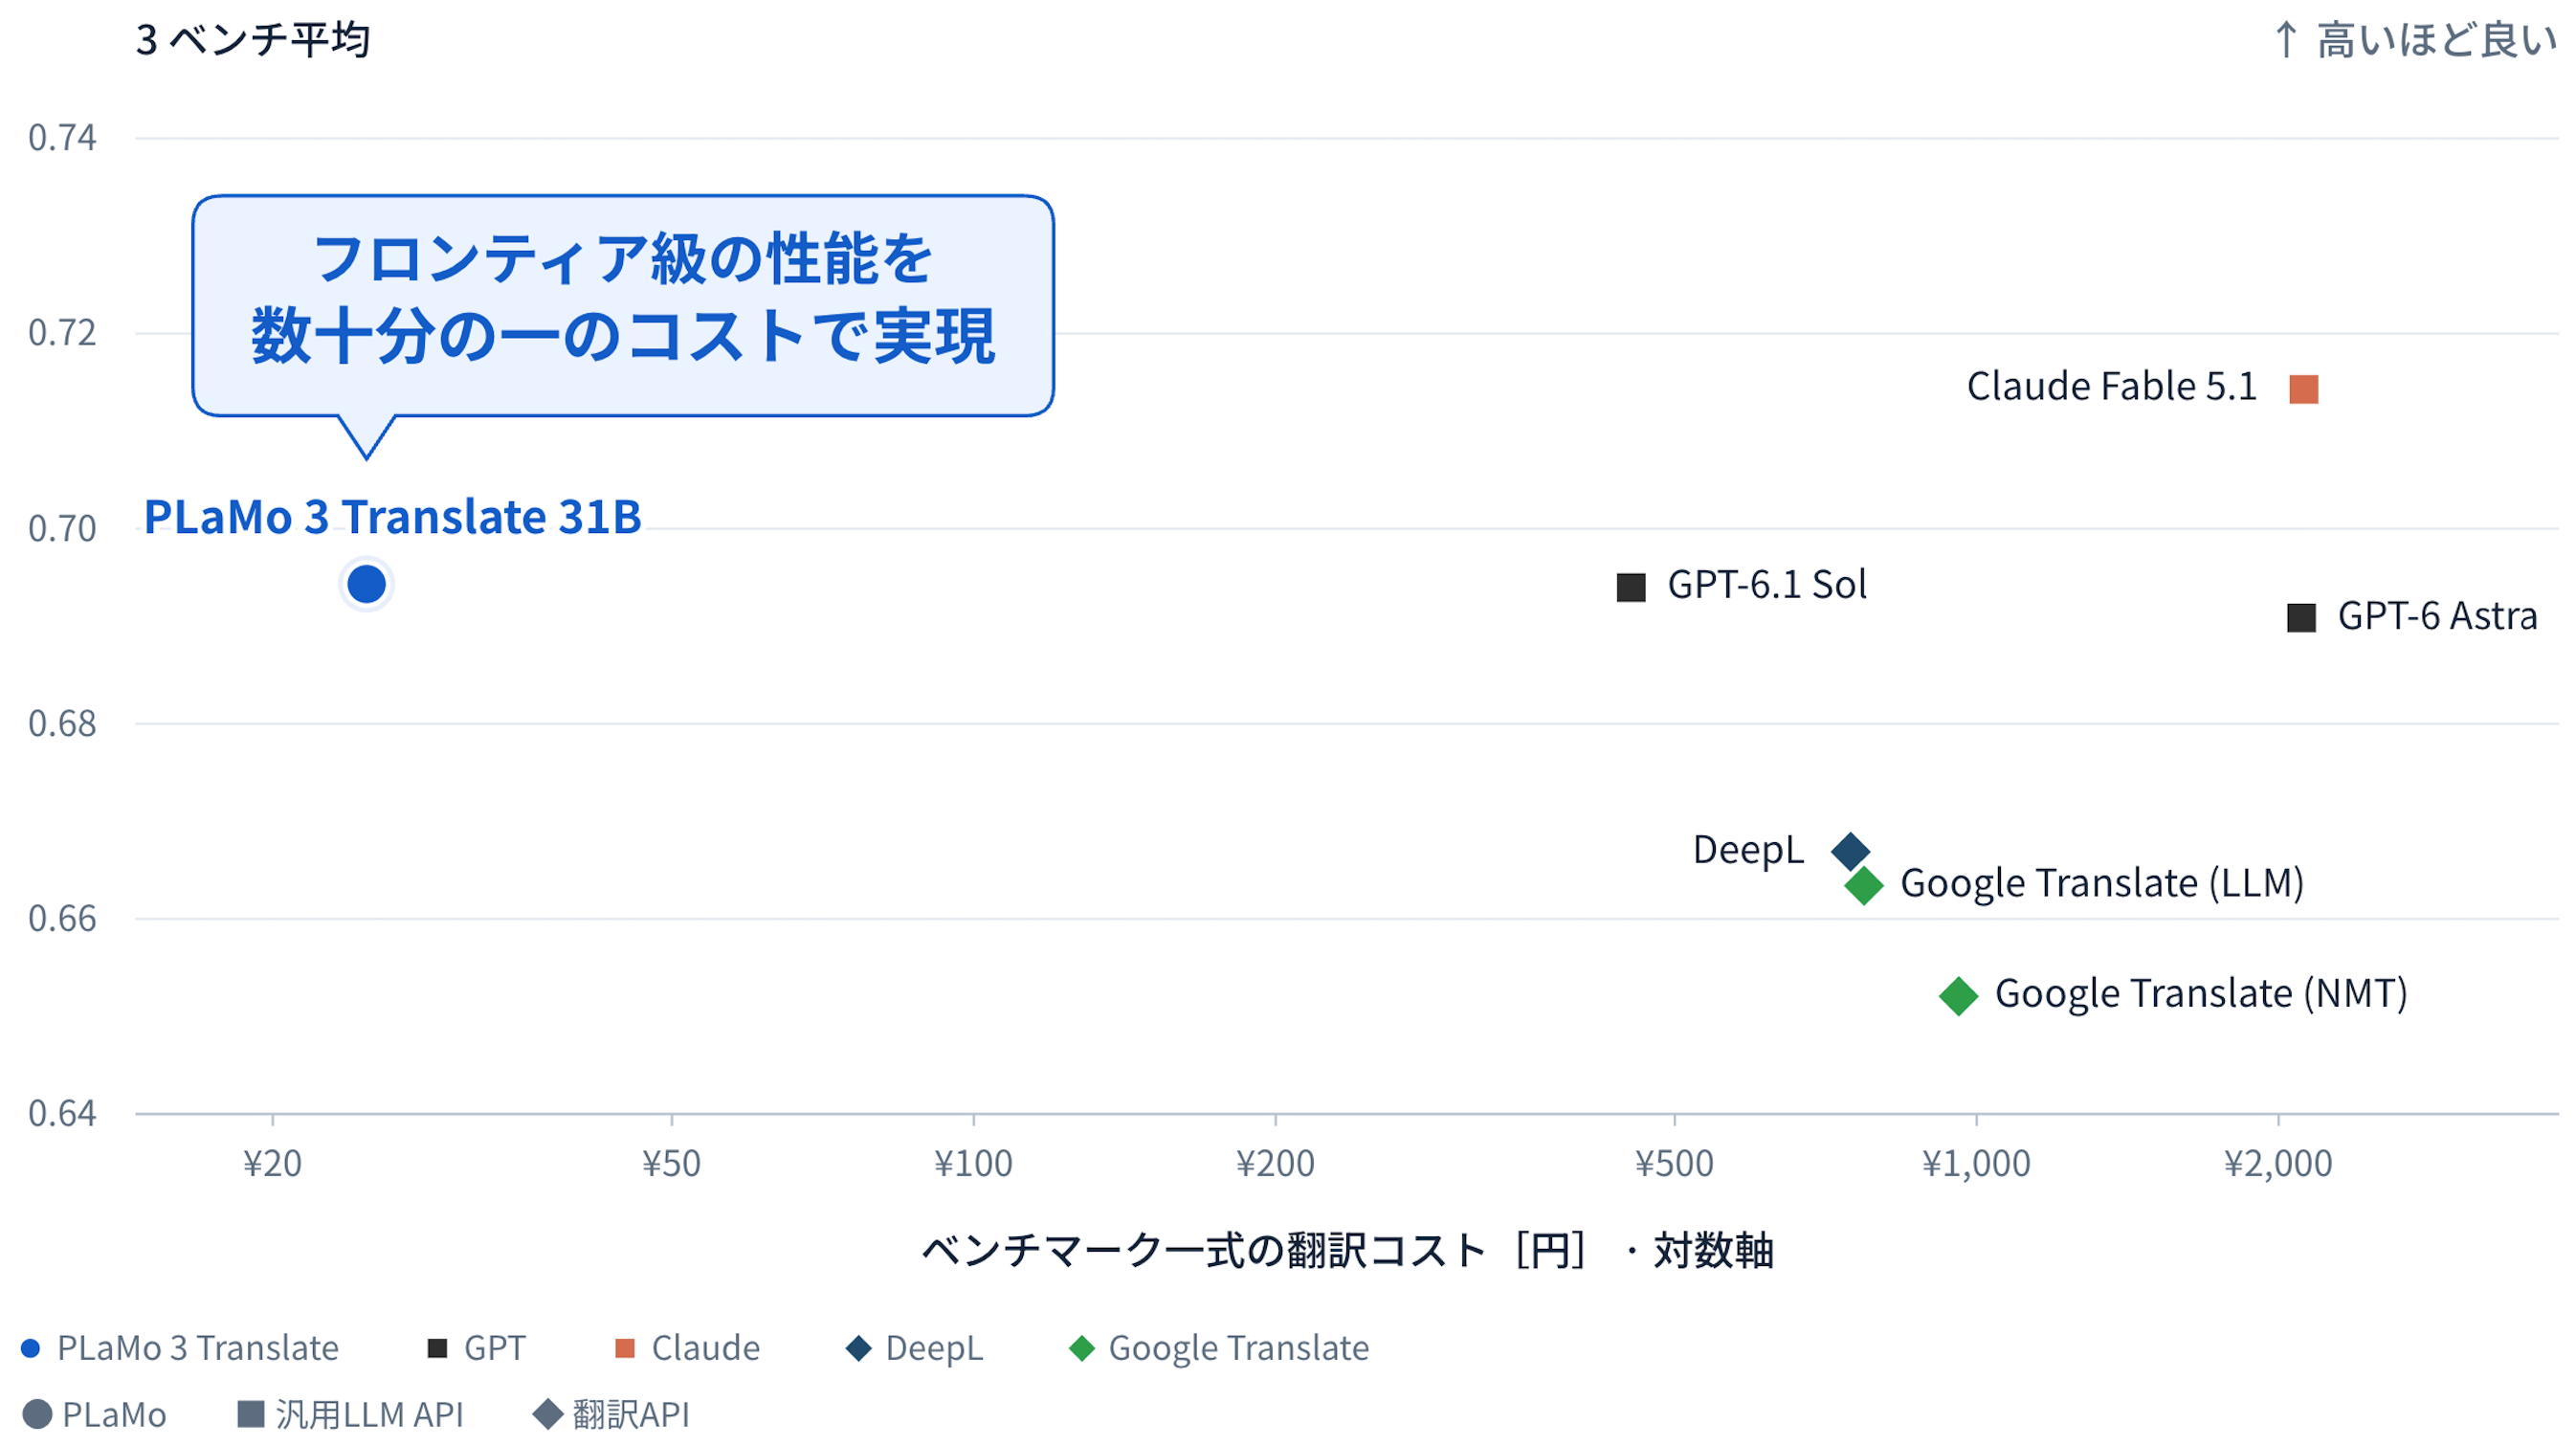
図1に日英・英日性能を、図2に多言語性能を示しています。どちらも、横軸をベンチマーク評価にかかったコスト (対数軸) とし、ベンチマーク性能を縦軸に示しています。左上に行くほど、安く性能が良いモデルであることを示します。
各APIサービスのコストは、2026年10月7日時点の公開単価と評価時の使用量から算出しました。PLaMo翻訳はAPIを現状公開していないため、PLaMo APIの料金(入力60円、出力250円/100万トークン)を仮に当てはめています。
日英性能を見ると、plamo-3-translate 31Bは、ほぼ全ての翻訳・LLM APIを上回る性能を示しています。更には、コスト面においては比較対象の翻訳・LLM APIと比べておおむね1/30前後のコストでこの性能を達成しています。唯一plamo-3-translate 31Bを上回るのはClaude Fable 5.1ですが、こちらと比較するとplamo-3-translate 31Bのコストは約1/85です。
多言語性能においても概ね同様の傾向を示し、日英性能ほどではないにせよ、翻訳・LLM APIの大半を上回るスコアを、数十分の一のコストで実現することが出来ています。
総合して、世界最高クラスの翻訳特化モデルを、極めてコスト効率に優れた形で実現することが出来たと考えています。
今回の評価は参照訳に依存する側面があるため、翻訳同士をLLMに比較させる評価も行いました。以下はplamo-3-translate 31BをDeepL翻訳、Google翻訳(Translation LLM)と対戦させたときの31B側の勝率です。
対戦相手 | PFTB 英 → 日 | PFTB 日 → 英 | SaaS 英 → 日 | WMT24++ 英 → 日 |
DeepL翻訳 | 87.00% | 58.00% | 73.82% | 59.17% |
Google翻訳 | 86.00% | 71.00% | 91.47% | 70.62% |
各サンプルについて、Gemini 3.1 Proが二つの訳文の提示順を入れ替えて2回判定しました。判定が割れた場合は双方に0.5勝としています。互角の場合は勝率が50%になります。
いずれのベンチマークでもplamo-3-translate 31Bが勝利していますが、PFTBやSaaSを見ると、特に日本語出力で顕著に差をつけて勝利することが出来ています。
このような大きな性能向上の背景には、以下の要因が考えられます。
PLaMoモデル自体の日本語能力の高さ: PLaMoのベースモデルでは、学習データに占める日本語の割合が30%近く、フロンティアモデルを遥かに上回る比率であり、自然な日本語を書く能力に優れています。
特化型LLMの強み: 翻訳という特定の目的に特化させることで、フロンティアモデルよりもずっと小さなplamo-3-translate 31Bでも優れた翻訳能力を獲得することができます。
大規模・高品質なデータでの翻訳特化学習: plamo-2-translate時代から改めてデータを丁寧に集め直し、更にLLMによるデータ合成を用いて、極めて高品質なデータを構築しています。plamo-2-translate時代と比べて、学習トークン量 / データ合成に投入した計算量は数百倍に達しています。
また、plamo-3-translateがコスト面で非常に良い結果を残せていることには、PFNで自社開発した独自のトークナイザ [10] を用いていることも大きな要因になっています。
モデル | 日本語出力(トークン/1,000文字) | 英語出力(トークン/1,000文字) |
plamo-3-translate | 447 | 205 |
Claude Fable 5.1 | 893 | 352 |
GPT-6 Astra | 744 | 224 |
PFTBベンチマークの英 → 日・日 → 英それぞれ50件で生成した訳文について、出力トークンの効率を計算しました。少ないほど同じ文字数を効率よく表現できていることを意味します。
日本語出力では、PLaMoのトークン数が特に少なくなっています。Claude Fable 5.1と比較して約2倍のトークン効率を実現しており、同じトークン単価・生成速度(token/sec)であれば、同じ文字数の出力にかかるコストが約半分になり、文字数ベースの生成速度が約2倍になります。
出力の例
plamo-3-translateの強みは、文脈を考慮したうえで流暢な日本語を記述してくれるところにあると考えています。これはベンチマークには現れにくい部分です。実際の文章例を以下に掲載します(※内部での細かいモデルのバージョンアップの関係などで、この通りの出力が常に再現されるわけではない点にご注意ください)。
例1: ビジネスメール
原文 | モデル | 訳文 |
I realize this adds another step for you. Could you send me the revised quote? If you just sent it, apologies if our emails crossed. | plamo-3-translate 31B | お手数をおかけして恐縮ですが、修正後の見積書をお送りいただけますでしょうか。もし既にお送りいただいている場合は、メールが行き違いになってしまい申し訳ございません。 |
他社翻訳サービス | これで、お手数をおかけすることになるのは承知しています。修正後の見積書を送っていただけますか?もし先ほど送っていただいたばかりであれば、メールのやり取りが重なってしまったようで申し訳ありません。 |
「お手数をおかけして恐縮ですが」「メールが行き違いになってしまい」など、これがビジネスメールの文脈であることを読み取って、丁寧な日本語を書こうとしている様子がうかがえます。
例2: お店の紹介
原文 | モデル | 訳文 |
The people behind Camberwell's Cafe Bunmorrow are opening a new spot with a 50-seat terrace. Try the popular sandwiches and house pickles. Oh, and pints! Lovely pints. | plamo-3-translate 31B | キャンバーウェルの「Cafe Bunmorrow」のスタッフが、50席のテラス席を備えた新店をオープンします。人気のサンドイッチと自家製ピクルスをぜひ味わってみてください。あ、それとビールも!最高の一杯ですよ。 |
他社翻訳サービス | キャンバーウェルの「Cafe Bunmorrow」を運営するチームが、50席のテラスを備えた新店舗をオープンします。人気のサンドイッチや自家製ピクルスをぜひお試しください。そうそう、パイントも! 最高に美味しいパイントです。 |
"pints" 自体はヤード・ポンド法で使われる体積の単位ですが、日本語で使われることはやや珍しい単位です(ビアガーデンなどでは使われますね)。この文脈においてはほとんどビールのことを指します。plamo-3-translate 31Bはこの意図を汲み取り、単位名をそのまま残さず「ビール」と訳しています。最後に「最高の一杯ですよ」と添えて、お店の紹介文らしく締めくくっています。
例3: 小説風の文章
原文 | モデル | 訳文 |
At the sound of the gate, Mira hurried outside. Rowan had just come home; when she threw her arms around him, he lifted her off her feet. “Oh, big brother, I’m not a little kid anymore!” she said. But she wouldn’t let go. | plamo-3-translate 31B | 門の音がして、ミラは急いで外へ出た。ちょうど帰宅したところだったローワンに抱きつくと、彼は彼女をひょいと抱え上げた。 「もう、お兄ちゃん、私もう小さい子じゃないもん!」と彼女は言った。けれど、離れようとはしなかった。 |
他社翻訳サービス | 門の音がすると、ミラは急いで外へ駆け出した。ちょうどローワンが帰宅したところだった。彼女が彼に飛びつくと、彼は彼女を空中に持ち上げた。 「お兄ちゃん、もう私は小さな子供じゃないのよ!」と彼女は言った。それでも、彼女は彼から離れようとはしなかった。 |
小説風の文章について、「彼女をひょいと抱え上げた。」「もう、お兄ちゃん、私もう小さい子じゃないもん!」のように、より日本語として小説らしい、自然な訳文を出そうとしている傾向がうかがえます。
例4: 特許文
原文 | モデル | 訳文 |
We claim: 1. A self-watering planter comprising a moisture sensor; a reservoir; and a valve configured to release water from the reservoir when the sensor detects dry soil. 2. The planter of claim 1, wherein the valve remains open for a period set by ambient temperature. | plamo-3-translate 31B | 請求項: 1. 水分センサと、貯水タンクと、前記センサが乾燥した土壌を検知したときに前記貯水タンクから水を放出するように構成されたバルブとを備える自動給水プランター。 2. 前記バルブが、周囲温度によって設定された期間、開放状態を維持する、請求項1に記載のプランター。 |
他社翻訳サービス | 我々は以下のとおり請求する。 1. 水分センサー、貯水タンク、および、センサーが土壌の乾燥を検知した際に貯水タンクから水を放出するように構成されたバルブを備える自動給水プランター。 2. 請求項1に記載のプランターにおいて、バルブは、周囲温度によって設定された期間、開いた状態を維持するものである。 |
原文の書きぶりからして、これは特許の文章であることがわかります。plamo-3-translate 31Bは、この文脈を汲み取り、「請求項:」から文章を開始しつつ、日本語の特許の文体に合わせて訳文を出力しています。
PLaMo翻訳SaaSがもたらす体験
実際の利用者の翻訳体験を改善するには、モデルの性能に加え、日々の用途に合った機能や使いやすさも重要です。PLaMo翻訳は、plamo-3-translateを翻訳モデルとして活用し、さまざまな翻訳シーンで快適に使えるサービスを目指しています。
ブラウザ翻訳
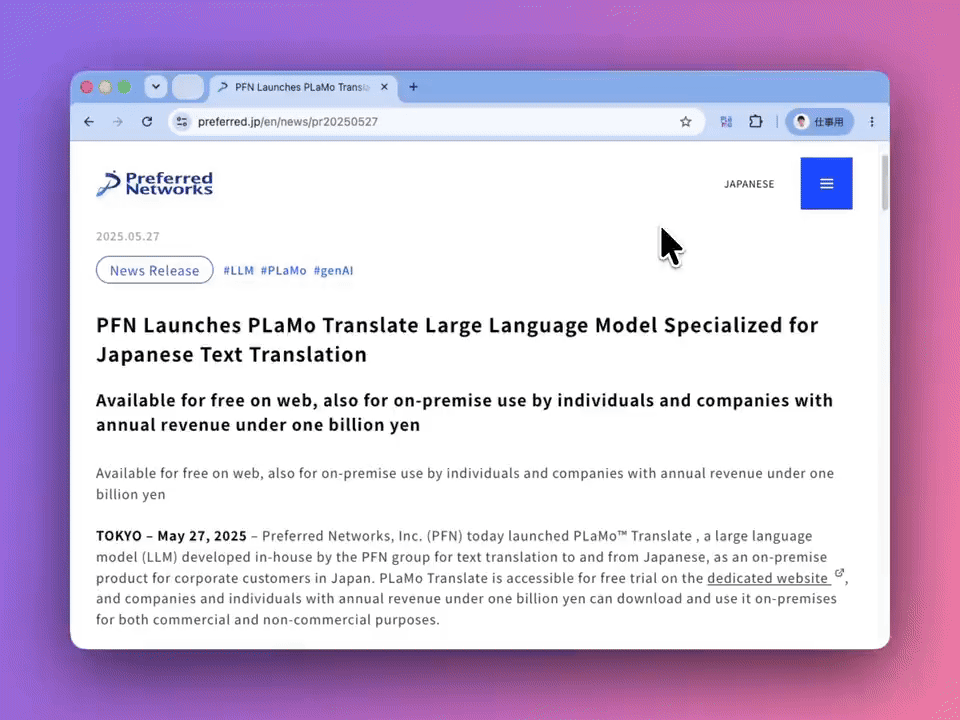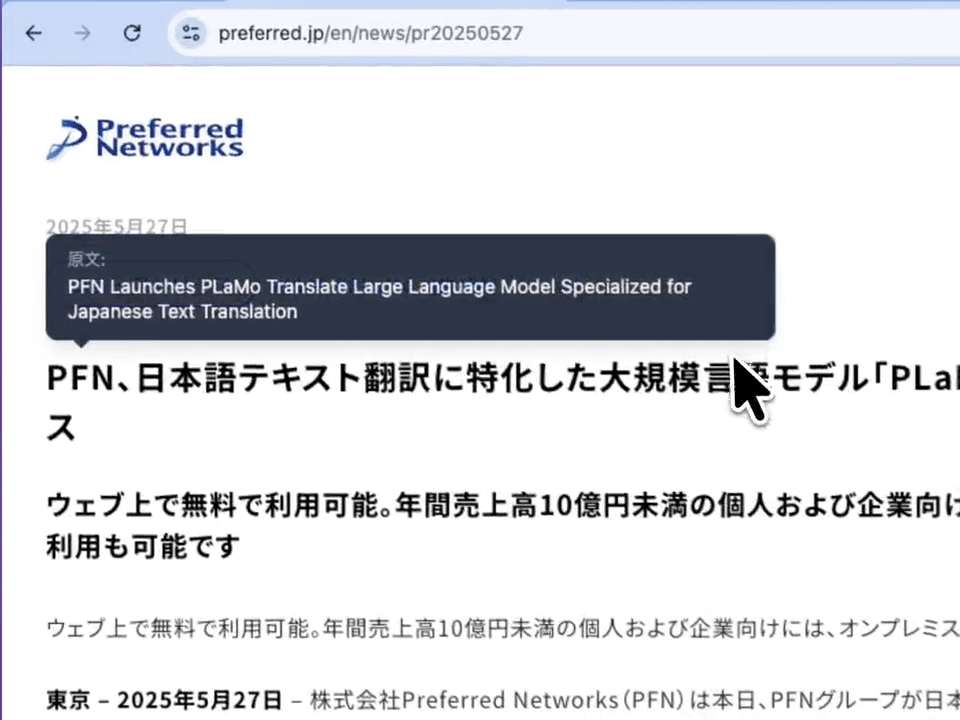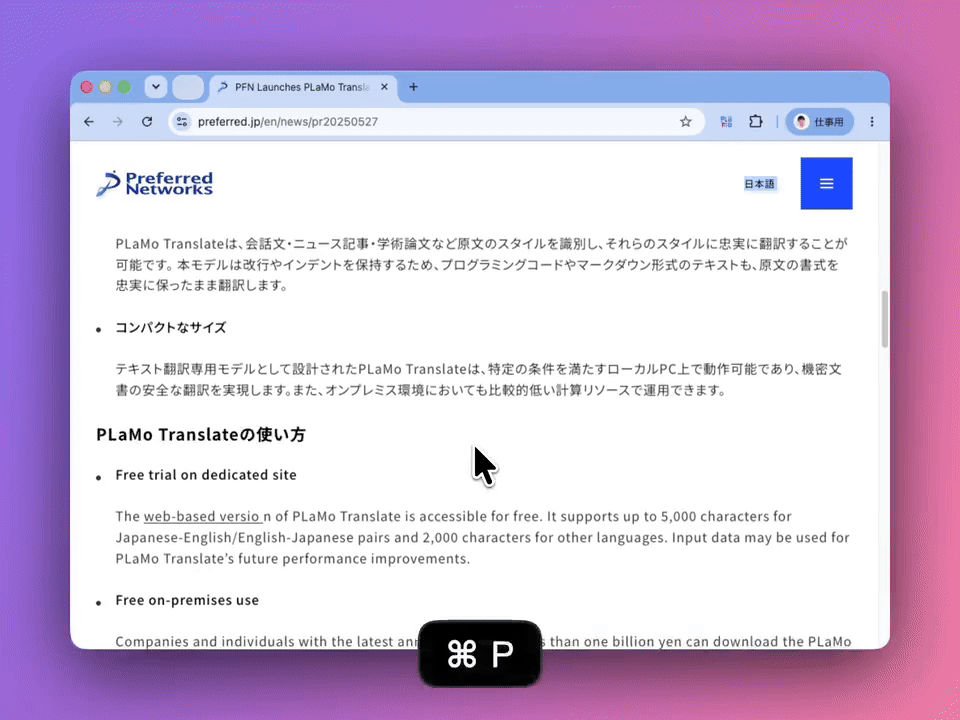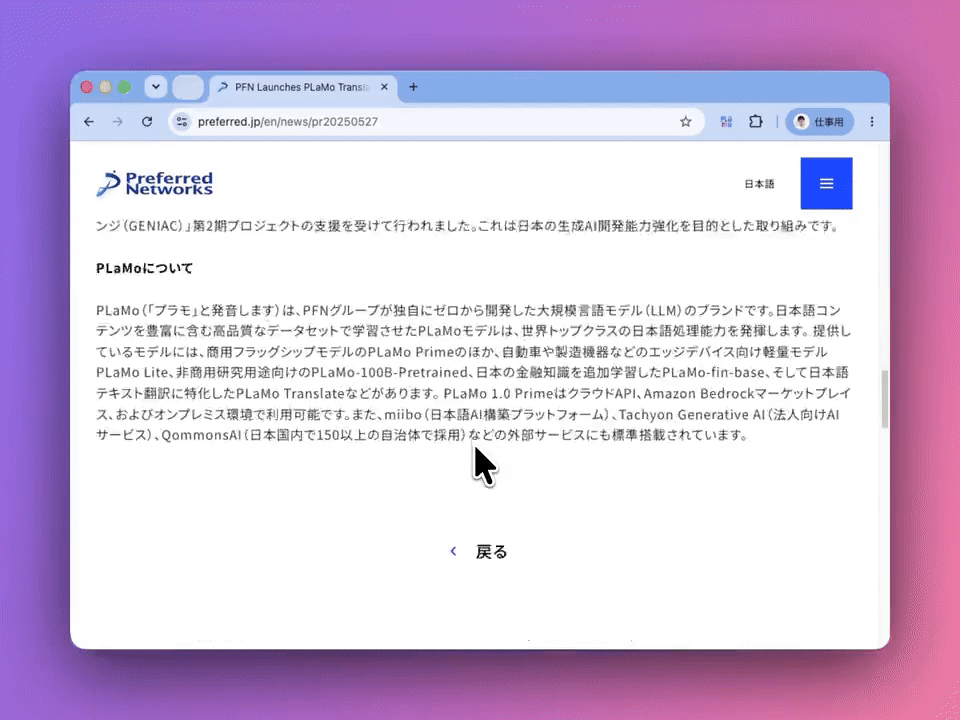
海外のニュースや技術記事を読むとき、文章をコピーして別の翻訳画面へ移す手間を減らせます。ブラウザ拡張からページを翻訳すると、そのまま、まるで最初から日本語で書かれたかのようにWebページを読むことが出来ます。
ファイル翻訳
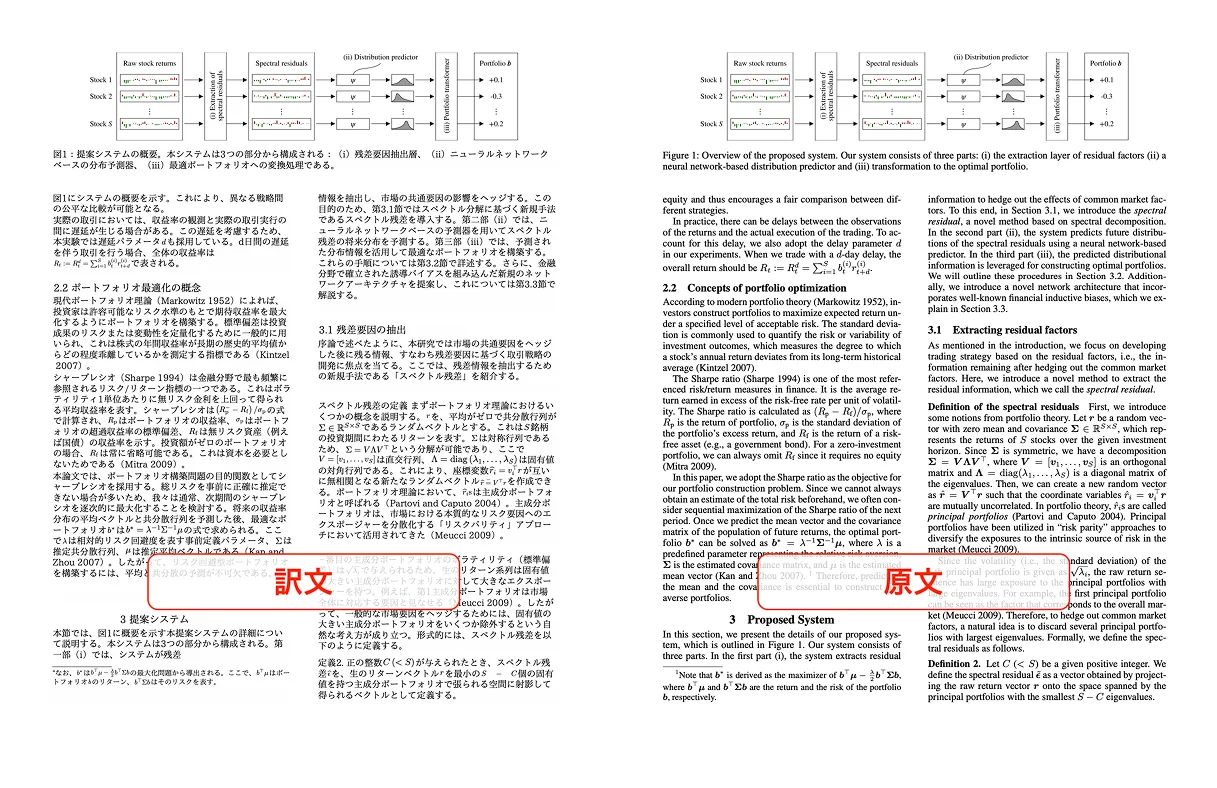
論文や資料をファイルごと翻訳するファイル翻訳機能も提供しています。ファイル翻訳ではレイアウト保持に拘っており、原文と訳文のページを以下のように左右に並べると、まるで人間が丁寧に組版し直したかのように自然なレイアウトで翻訳結果が描画されます。
会議翻訳
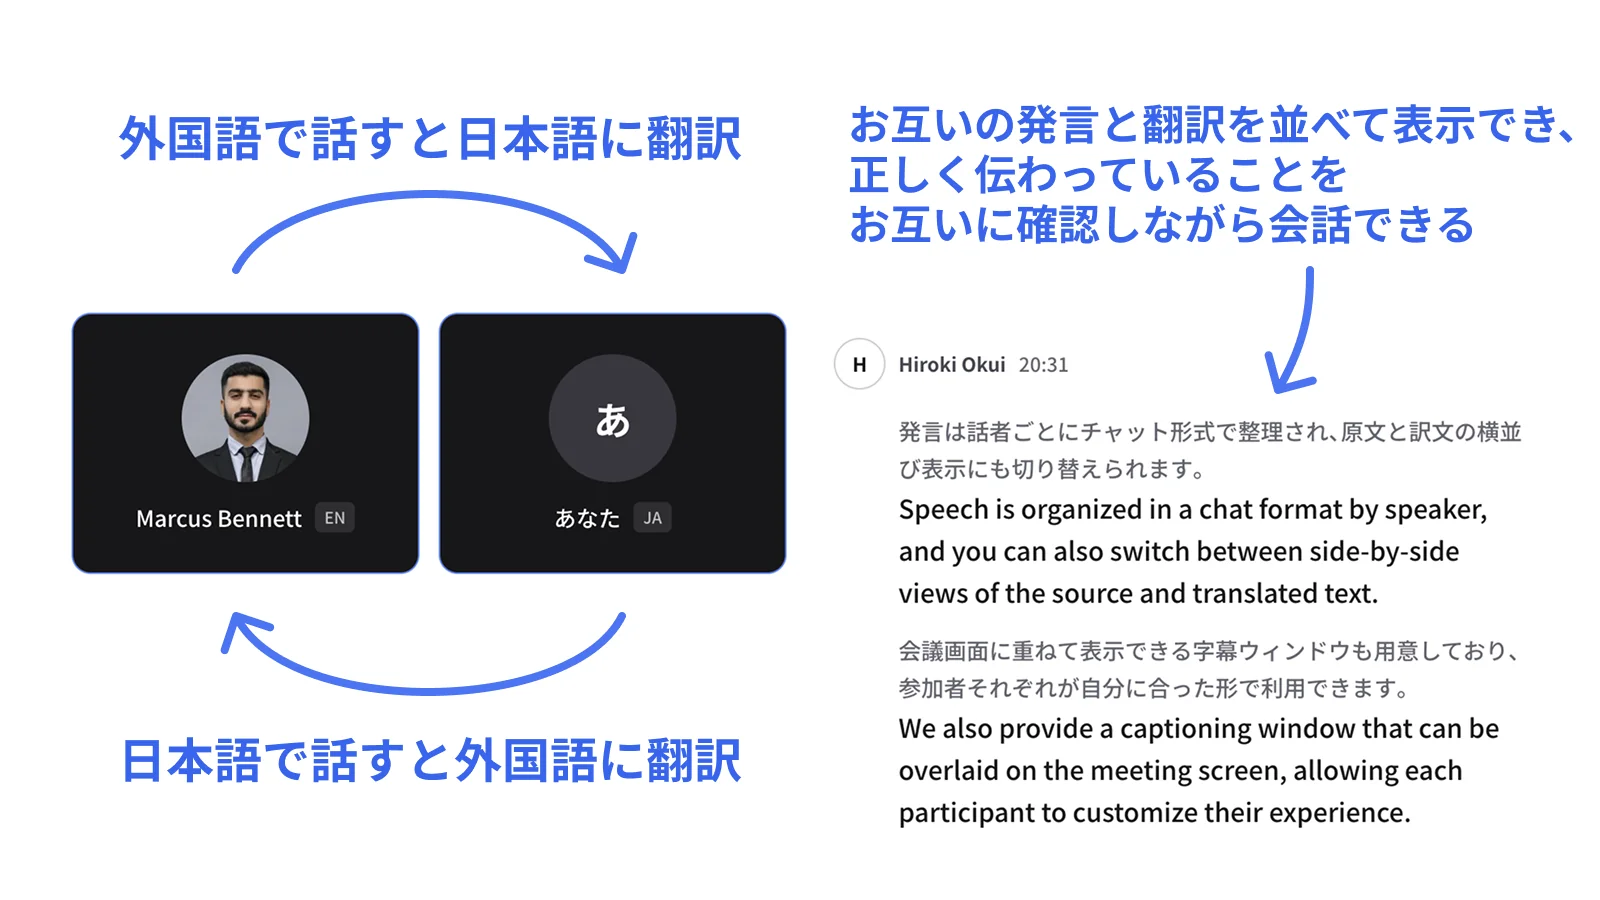
PLaMo翻訳では、会議翻訳機能の提供も開始しました。日英中などの3カ国語の話者が入り混じった状況でも、どの言語で話したのかを自動判定し他の言語にリアルタイムに翻訳するので、お互い自分の母語で話していても問題なく会議が成立するような体験を提供しています。
これら以外にも、PLaMo翻訳は英文添削やデスクトップアプリなど、多数の機能を備えています。ぜひPLaMo翻訳で試してみてください。
まとめ
- plamo-3-translateは、日英翻訳・多言語翻訳の双方で世界最高クラスの性能を、数十分の一のコストで実現しました。この性能は、PLaMo自体の日本語性能、独自トークナイザのトークン効率に支えられています。
- plamo-2-translateと比較しても圧倒的な性能向上を実現しました。翻訳データの大規模化と高品質化のために、数百倍の計算量を投入したことによる成果です。
- plamo-3-translateは既にPLaMo翻訳から利用できます。ぜひご利用ください。
- モデル重みの公開も予定しています。その際、開発の技術的な内容を紹介するTech Blogも公開予定です。
参考文献
[1] Preferred Networks. PLaMo翻訳. https://translate.preferredai.jp/
[2] Preferred Networks. PLaMo. https://plamo.preferredai.jp/
[3] Preferred Networks. plamo-2-translate. Hugging Face. https://huggingface.co/pfnet/plamo-2-translate
[4] Finkelstein, M. et al.(2026). “TranslateGemma Technical Report.” arXiv:2601.09012. https://arxiv.org/abs/2601.09012
[5] Deutsch, D. et al.(2025). “WMT24++: Expanding the Language Coverage of WMT24 to 55 Languages & Dialects.” Findings of the Association for Computational Linguistics: ACL 2025, pp. 12257–12284. https://doi.org/10.18653/v1/2025.findings-acl.634
[6] Rei, R. et al.(2022). “COMET-22: Unbabel-IST 2022 Submission for the Metrics Shared Task.” Proceedings of the Seventh Conference on Machine Translation (WMT), pp. 578–585. https://doi.org/10.18653/v1/2022.wmt-1.52
[7] 今城健太郎・平野正徳(2026). 「高精度翻訳モデルのための自動評価手法の検討」. Jxiv, プレプリント. https://doi.org/10.51094/jxiv.2428
[8] Open Language Data Initiative. FLORES+. Hugging Face. https://huggingface.co/datasets/openlanguagedata/flores_plus
[9] Popović, M.(2017). “chrF++: words helping character n-grams.” Proceedings of the Second Conference on Machine Translation, pp. 612–618. https://doi.org/10.18653/v1/W17-4770
[10] 今城健太郎(2025). 「大規模言語モデル PLaMo 2 のためのトークナイザ性能改善」. Preferred Networks Blog. https://www.preferred.jp/ja/blog/tech/plamo-2-tokenizer
*1 PLaMo翻訳のLLMは、PFNと国立研究開発法人情報通信研究機構(NICT(エヌアイシーティー))の共同研究で得られた事前学習モデル「PLaMo 3 NICT」を基盤として、PFNが開発した翻訳特化型モデルです。