概要
- 翻訳特化LLM PLaMo 3 Translateの重みをHugging Faceで公開しました。0.8B、2B、8B、31Bの4サイズのモデルを開発・公開しており、最小の0.8Bモデルでも、日英および日本語↔多言語で30倍以上大きな既存の翻訳特化LLMを上回る性能を達成しました。
- 開発の鍵は、「トーナメント式データ合成」「逆翻訳」「反復的自己蒸留」などによる徹底的なデータの洗練と、小型モデルへの蒸留です。本Tech Blogでは、これらのモデルの開発プロセスと性能について説明します。なお、フロンティアLLM APIや翻訳APIとの比較については、以前のリリースブログ [1] をご参照ください。
公開するモデル重み一覧
PLaMo 3 Translateには、0.8B、2B、8B、31Bの4つのモデルサイズがあります。これらの全てをHugging Faceで公開します。各サイズについて、BF16の重みに加え、各種量子化モデルやGGUF・MLX形式のモデルも用意しています。利用環境に合わせてモデルをお選びください。
量子化はAutoRound [2] などを用いて実施しており、今回のベンチマークでは、いずれの量子化形式においても、BF16版からの精度劣化を最小限に抑えられることを確認しています。詳細はモデルカードをご参照ください。
PLaMo 3 Translateモデルは、53言語の多言語翻訳に対応している他、周辺コンテキスト、翻訳用語集、常体/敬体の指定などの翻訳オプションを備えています。使い方の詳細は、Hugging Face上の各モデルのモデルカードをご覧ください。
PLaMo 3 Translateは、PLaMoコミュニティライセンスのもとで公開しています。個人での学習や趣味など、私的な用途であれば、モデルを無償でダウンロードし、自由にご利用いただけます。学術用途を含む非商用利用では、収入や売上の規模による制限はなく、PFNへの事前の利用登録も不要です。
商用利用も、利用者またはその関係会社の直近事業年度の収入または売上が10億円以下であれば、専用フォームで事前登録することで無償で利用できます。10億円を超える場合の商用利用については、別途ライセンス契約が必要となりますので、PFNまでご相談ください。
配布形式の選び方は以下などが参考になるかと思います。
| 形式 | 主な対象環境 | 推論エンジン | 用途の目安 |
|---|---|---|---|
| BF16 | BF16対応GPU | Transformers/vLLM [3] | 量子化なしの精度を優先。メモリに余裕がある場合 |
| FP8 | NVIDIA Ada Lovelace/Hopper/Blackwell | vLLM [3] | 精度と省メモリ・速度のバランスを重視 |
| W4A16 | NVIDIA Ampere以降 | vLLM [3] | 4bit重みでGPUメモリを抑えて実行 |
| W4AFP8 | NVIDIA Hopper | vLLM [3] | 4bit重みとFP8演算で、省メモリと処理量の両立を狙う |
| NVFP4 | NVIDIA Blackwell | vLLM [3] | FP4演算を活用し、省メモリ・高速化を狙う |
| GGUF | CPU/各種GPU | llama.cpp [4] | 手元のPCで実行。CPUとGPUの併用も可能 |
| MLX-4bit | Apple silicon | mlx-lm [5] | Macで省メモリに実行 |
ユースケースの例
PLaMo 3 Translateは0.8Bモデルでさえも非常に強力な翻訳能力を持ちます。これにより、既存のLLMでは実現し得なかった全く新たなユースケースを切り拓くことも可能であると考えています。
一つの例はオンデバイス推論です。以下はPLaMo 3 Translate 0.8Bを用いて、スマートフォン上のオンデバイス推論で翻訳を行っている様子です(これは社内で構築したデモ環境であり、こういったアプリ自体を現時点でPFNがリリースしているわけではありません)。
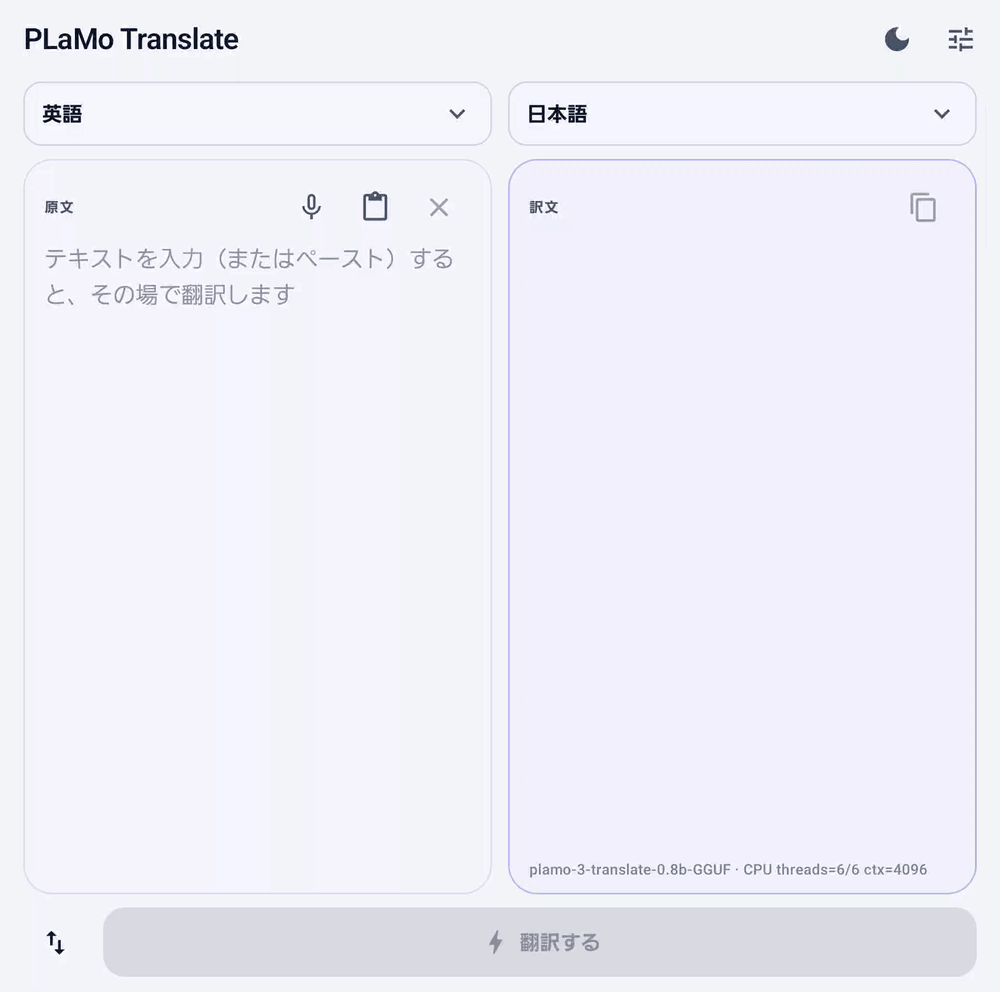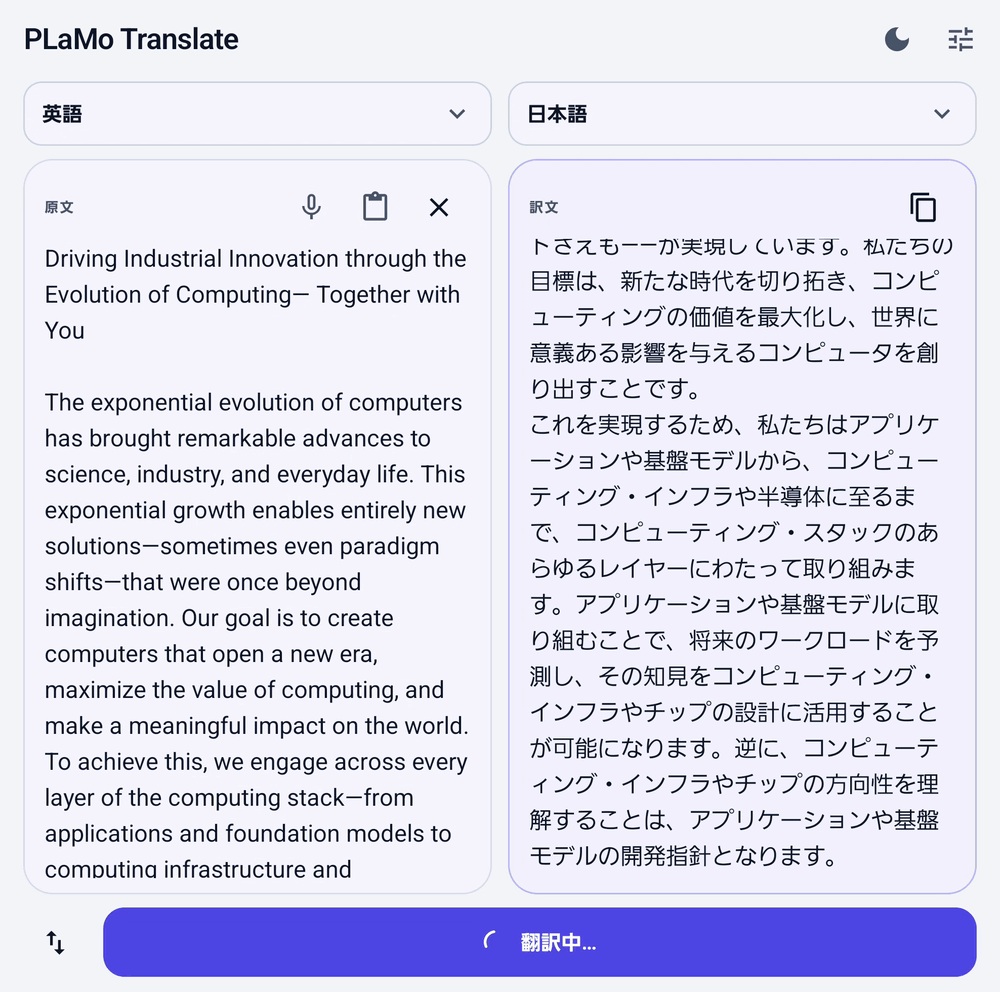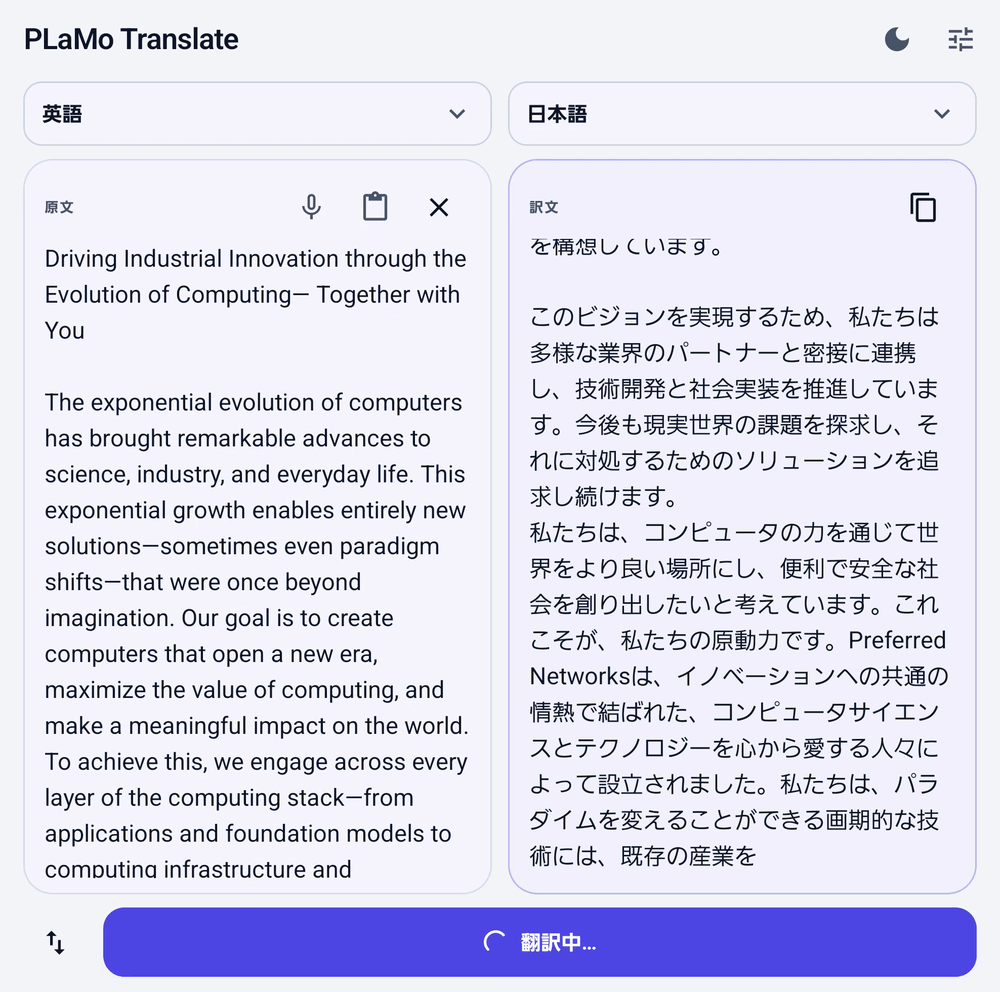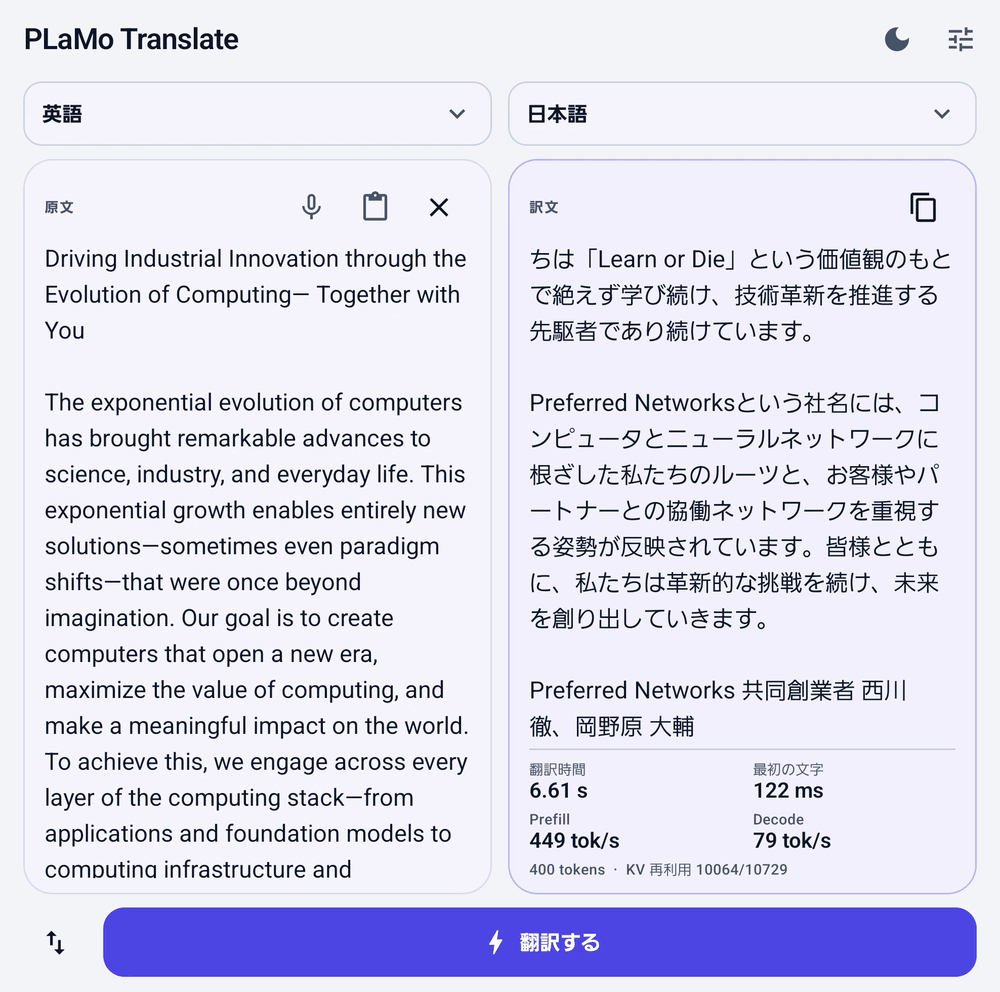
以下に示すように、機内モード、すなわちインターネットに繋がっていない環境であっても、非常に高速かつ自然な翻訳体験を提供することが出来ます。推論基盤に合わせて、小さめのLLMも含めた様々なモデルをリリースすることで、こういった新たなユースケースを開拓することができると考えています。
学習の全体像
PLaMo 3 Translateの学習の全体像を以下に示します。
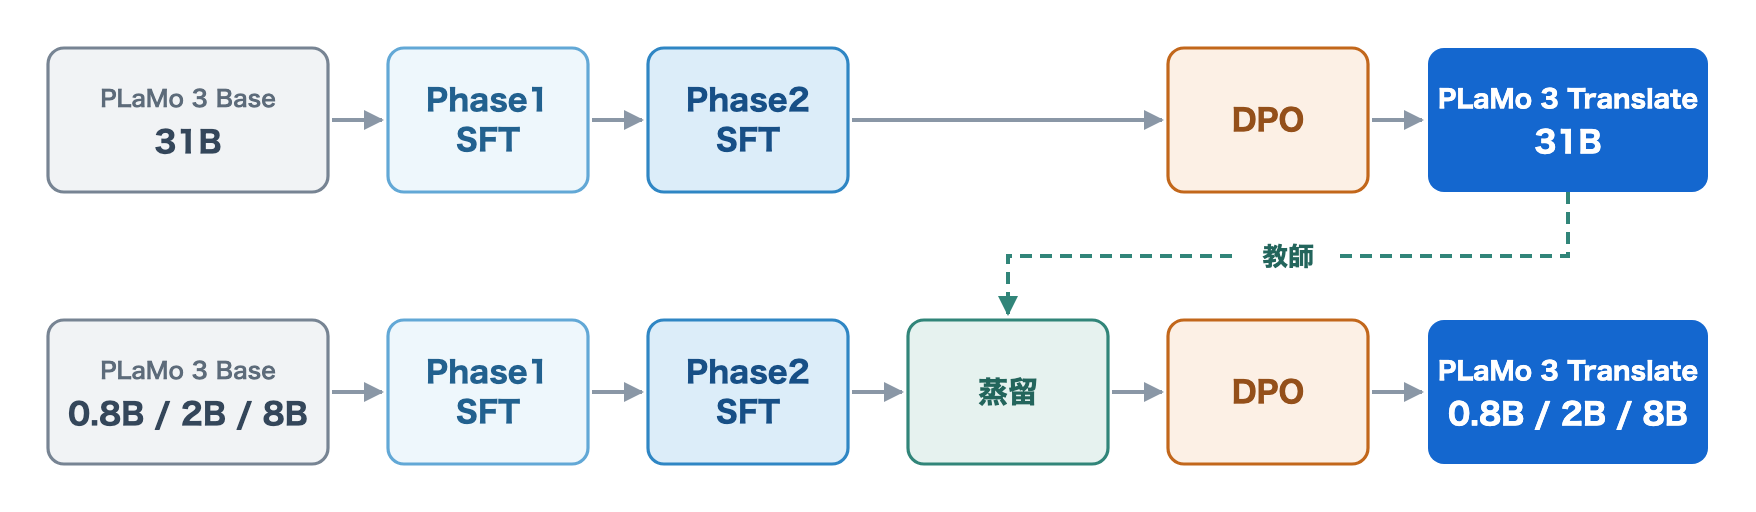
PLaMo第3世代 (*1) のベースモデル(事前学習のみが終わった状態のモデル)から出発し、2段階のSFT (Supervised Fine-Tuning) の後にDPO (Direct Preference Optimization) [6] を実施しています。これは、それぞれ以下のような学習です。
Phase1 SFT
- (原文、訳文)のペアデータを用いて、原文を入力して訳文を出力するように学習します。
- 大量のデータを用いて学習します。これにより、まずはモデルを翻訳タスクに適応させ、基礎的な翻訳能力を獲得させることを狙います。
Phase2 SFT
- Phase1と同じく、(原文、訳文)のペアデータを用いて、原文を入力して訳文を出力するように学習します。
- Phase1 よりも実ユースケースに近い多様な原文を集めつつ、それに対して合成する訳文をPhase1以上に徹底的に洗練します。これにより、Phase1と合わせて「大規模データでの学習 → 少量だがより高品質なデータでの学習」という流れを構築し、翻訳モデルとしての性能を更に引き上げることを狙います。
DPO
- 同じ原文に対する複数の翻訳候補から、より好ましい訳文(chosen)と比較対象の訳文(rejected)を選びます。chosenをrejectedよりも生成しやすくするように学習し、翻訳品質の仕上げを行います。
8B以下のモデルに対しては、更にSFTとDPOの間に31Bモデルからの蒸留を実施しています。これは、一度完成した大きなモデルの能力を最大限活用して、小さいモデルの性能を更に引き上げることを狙った学習です。
各段階について、以下で詳細を説明します。
評価
学習の説明に入る前に、PLaMo 3 Translateの開発にあたって行っていた、翻訳性能の評価について説明します。
今回は以下の4種類のベンチマークを用いていました。
- PFTBベンチマーク
- SaaSベンチマーク
- WMT24++ [7]
- FLORES+ [8]
以下で詳細を説明します。
PFTBベンチマーク
社内で開発した、幅広い分野の日英・英日翻訳の性能を計測するベンチマークです。学術論文、製品レビュー、詩に至るまで幅広い分野の原文を集め、必要に応じて編集した後、複数の強力なLLMを用いて高品質な参照訳を付与して構築しています。
以前にPFNで行った「高精度翻訳モデルのための自動評価手法の検討」 [9] の研究により、十分に高品質な参照訳があればn-gramベースの評価指標により優れた性能評価ができることが分かっています。これに基づき、参照訳との間のn-gramベース類似度を計算し、それをスコアとしています。n-gramベース類似度の実装としてはcharsim [10] を用いています。
具体的なデータの例を以下に示します。1つ1つの文章自体がある程度の長さを持ち、複雑な翻訳課題を提示するベンチマークになっています。
| 原文 | 参照訳 |
| 英 → 日の例 | |
| Tokugawa Ieyasu (born Matsudaira Takechiyo; January 31, 1543 – June 1, 1616) was the founder and first shōgun of the Tokugawa shogunate of Japan, which ruled from 1603 until the Meiji Restoration in 1868. He was the third of the three "Great Unifiers" of Japan, along with his former lord Oda Nobunaga and fellow Oda subordinate Toyotomi Hideyoshi. The son of a minor daimyo, Ieyasu once lived as a hostage under daimyo Imagawa Yoshimoto on behalf of his father. He later succeeded as daimyo after his father's death, serving as ally, vassal, and general of the Oda clan, and building up his strength under Oda Nobunaga. | 徳川家康(幼名:松平竹千代、1543年1月31日 – 1616年6月1日)は、1603年から1868年の明治維新まで日本を統治した徳川幕府の創設者であり、初代将軍である。日本の「三英傑」の三人目であり、かつての主君である織田信長、同じく織田氏の家臣であった豊臣秀吉と並ぶ。小大名の子であった家康は、かつて父の名代として大名・今川義元のもとで人質として暮らした。父の死後、家督を継いで大名となり、織田氏の同盟者、家臣、武将として仕え、織田信長のもとで勢力を築いた。 |
| 日 → 英の例 | |
| こんにちは、オンライン英会話スクールのプリファードです! この度、オンライン英会話スクールでは、初月無料キャンペーンを実施いたします! この機会に、自宅で気軽に英会話を始めてみませんか? キャンペーン期間 2029年11月1日 ~ 2029年11月30日 ★キャンペーンの魅力 ① 初月無料! 期間中に登録すると初月のレッスン料金が無料! ② 人気講師のレッスンが受け放題! 豊富な講師陣の中から、自分に合った講師を選べます。 ③ 無料教材も充実! 初心者でも安心して学べる教材をご用意しています。 ★おすすめレッスンピックアップ おすすめ1: 初心者向け英会話 おすすめ2: ビジネス英会話 その他、様々なニーズに合わせたレッスンをご用意! 【キャンペーンを賢く利用するコツ】 ・ 今すぐ登録して、初月無料の特典をゲット! ・ レッスンスケジュールを確認して、計画的にレッスンを受けよう! ▼今すぐチェック! https://www.preferred.jp/ このチャンスを逃さず、新しい自分への一歩を踏み出してみませんか? 皆さまのご参加を心よりお待ちしております! | Hello, this is Preferred, your online English conversation school! We're now running a first-month-free campaign at our online English conversation school! Why not take this opportunity to start learning English conversation from the comfort of your home? Campaign Period November 1, 2029 – November 30, 2029 ★Campaign Highlights ① First month free! Register during the campaign period and your first month's lesson fees are free! ② Unlimited lessons with popular instructors! Choose from our extensive roster of instructors to find the one that's right for you. ③ Comprehensive free learning materials! We offer materials that even beginners can study with confidence. ★Recommended Lesson Picks Recommendation 1: English Conversation for Beginners Recommendation 2: Business English Conversation Plus a variety of lessons tailored to diverse needs! 【Tips for Making the Most of This Campaign】 ・ Register now and grab your first-month-free benefit! ・ Check the lesson schedule and plan your lessons ahead! ▼Check it out now! https://www.preferred.jp/ Don't miss this chance—why not take the first step toward a new you? We sincerely look forward to your participation! |
SaaSベンチマーク
社内で開発した、PLaMo翻訳SaaSの体験と直結するよう、実際のリクエストに近いフォーマットでの性能を計測するベンチマークです。現状は英 → 日方向のみのベンチマークになっています。PFTBベンチマークと同じく、参照訳との間のcharsimにより性能を計測します。
具体的なデータの例を以下に示します。翻訳SaaSでの必要性に基づき、実際のWebページを、ブラウザ拡張の体験を最大化できるよう、HTMLタグなどは維持したまま翻訳することを要請するベンチマークになっています。また、例には含めていませんが、周辺のコンテキストも翻訳指示の一環として与えられます。
| 原文 | 参照訳 |
| For example, for <code>Date</code> instances, you can use a range of methods to get different information from a single date value, such as the <a href="0">year</a>, <a href="1">month</a>, <a href="2">day of the week</a>, etc. You can also set those values through the <code>setX</code> counterparts like <a href="3"><code>setFullYear</code></a>. | 例えば、<code>Date</code>のインスタンスでは、1つの日付値から<a href="0">年</a>、<a href="1">月</a>、<a href="2">曜日</a>などのさまざまな情報を取得するために、各種メソッドを使用できます。それらの値は、<a href="3"><code>setFullYear</code></a>などの<code>setX</code>系の対応メソッドを通じて設定することもできます。 |
WMT24++
WMT24(Ninth Conference on Machine Translation)で用いられた評価データを基に、英語から55の言語・方言への翻訳を評価できるよう拡張したベンチマークです。今回は日本語トラックを対象とし、英 → 日のベンチマークとして扱っています。性能計測指標として COMET-22 [11] を用いています。
全体的に短文で構成されることや、参照訳のクオリティにやや懸念がある傾向が見られることなどから、実際の開発においては主にPFTB / SaaSベンチマークのスコアを参照していました。
FLORES+
多言語性能の計測のために用いているベンチマークです。次の言語を計測対象としています (*2)。
アラビア語、イタリア語、インドネシア語、英語、日本語、オランダ語、韓国語、スペイン語、タイ語、中国語(簡)・中国語(繁)、ドイツ語、フランス語、ベトナム語、ロシア語
全ての言語ペアについて翻訳性能を計測するとコストが大きいため、「日本語 ↔ 多言語」「英語 ↔ 多言語」の性能を計測しています 。
性能計測指標としてchrF++ [12] を用いています。「多言語 → 日本語」の性能計測においては、常体/敬体のブレによってスコアが大きく変わるのを避けるため、各モデルに対して敬体で翻訳するように明示しています。
データの構築
翻訳モデルの学習のためには、(原文、訳文) のペアデータを大量に用意する必要があります。PLaMo 3 Translateの開発においては、原文をWebなどから収集し、訳文をLLMによって合成するアプローチによってほとんどのデータを構築しています。
原文データの収集
原文データの収集には様々な方法を組み合わせています。用いた方法の1つは、大規模なWebコーパスからのマイニングです。マイニングにあたっては、以下の点に注意しています。
- スパムページを入れすぎない
- なるべく多様な文章を集める
- 言語が混ざらないようにする
- 他の言語から機械翻訳された文章ではなく、なるべくその言語のネイティブの文章を収集する
後述しますが、ペアデータの構築の際に、集めた原文を逆翻訳で加工したものが出力に入ることがあります。このため、翻訳モデルの学習に用いられる出力文をなるべくきれいな文章にするべく、これらの方針を定めています。
マイニングはルールベース・クラスタリングなどを組み合わせて実施しています。また、各言語圏の特性を考慮し、言語ごとに異なるルールを実装しています。無数のルールがありますが、ごく一部を代表例として挙げると、以下のようなルールでマイニングを実施しています。
- スパムページに多い単語の密度を計測し、スパムの可能性が高いページを除外する
- 1ホストあたりの採用量に上限を設け、なるべく多様なホストからマイニングする
- クラスタリングの結果を考慮し、マイニングする文章の分野の多様性を向上する
- 日本語の文章に、日本語では通常使われない中国語特有の文字が入っていた場合、中国語の混入とみなしてその文章を除外する
- 中国語の簡体字と繁体字は漢字を機械的に置換することで変換ができるが、片方からもう一方に機械的に変換された文章は、簡体字 / 繁体字のネイティブの文章とは少し異なると考える。変換ツール特有の誤変換や、簡体字圏・繁体字圏それぞれに特有の語彙の比率を調べて、変換由来の文章をなるべく除外する
- インドネシア語のデータ収集時には、よく似たマレー語が混ざらないように専用の単語ベースフィルタリングを構築する
- 機械翻訳由来の文章が多数含まれると思われるドメインを除外する
訳文の合成
原文データが収集できたら、次はLLMによって訳文を合成します。訳文の合成には、Gemma 4 31B IT [13] を採用しました。オープンモデルの中でも、モデルサイズに対して高い性能を発揮し、多言語にも強いことが採用の理由です。
単にLLMに翻訳するよう指示するだけではなく、より洗練された訳文を合成するために複数の工夫を組み合わせています。
- トーナメント式データ合成
- 逆翻訳
- 反復的自己蒸留
これらのアプローチについて順に説明します。
トーナメント式データ合成
トーナメント式データ合成のイメージ図を以下に示します。
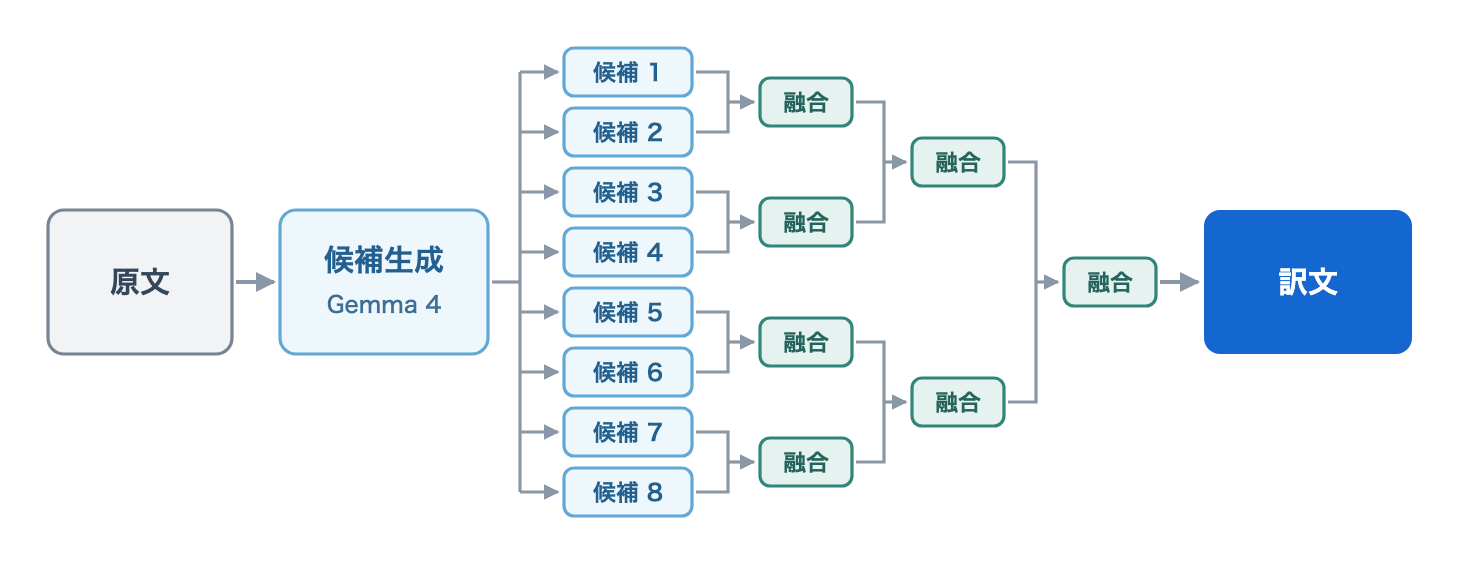
Gemma 4は強力なオープンモデルですが、一発出しの翻訳の性能には多くの場合改善の余地が残ります。LLMに一発で訳文を出させる代わりに、より大きな計算コストをかけて何度も推論させることで、よりよい訳文を合成することを考えます。
PLaMo 3 Translateの開発では、このために独自のトーナメント式データ合成を用いました。これは、最初に複数の翻訳候補を出させ、その翻訳候補同士をGemma 4で「融合」させることによる改善を、トーナメント形式で繰り返す手法です。融合では、2つの翻訳候補を比較させて勝者を決定しつつ、敗者側の翻訳に良い点があれば勝者側に取り込んで、よりよい訳文になるように改善します。
予備実験では、多数の候補を生成して良いものを選ぶ方法など、複数のアプローチを比較しました。その結果、トーナメント式データ合成で最も質の高い訳文を生成できることが分かりました。
逆翻訳
逆翻訳のイメージ図を以下に示します。
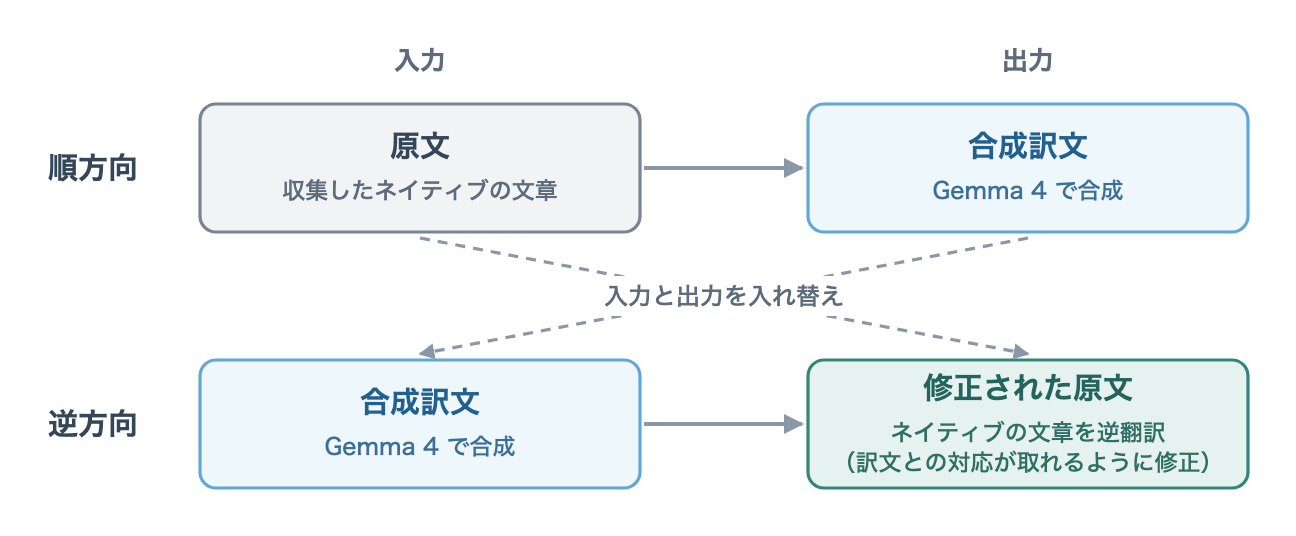
原文の収集時には、各言語のネイティブが書いた文章を集めるよう注意しました。そのため、原文側は各言語の自然な文章で構成されています。これに対して先程のトーナメント式データ合成で訳文を合成することで、順方向、すなわち 原文 → 合成訳文 のデータを作ることが出来ます。これは、「ネイティブの流暢な原文を読むことを学ぶ」データの役割を担います。
一方で、この方向のみの学習では翻訳モデルに学ばせる出力側の文章がLLMによる合成文のみになってしまいます。これだとモデルの出力の流暢性が落ちてしまうと考え、逆方向のデータを構築します。すなわち、合成訳文 → 原文 のデータを構築します。これは、「ネイティブの流暢な原文を書くことを学ぶ」データの役割を担います。
このように、人が書いた自然な文章を教師データとして用いることで、データ合成に使ったLLMを上回る翻訳性能を持つモデルを学習できる可能性があります。ただし、原文と訳文を単純に入れ替えて、逆方向の教師データとして使えるとは限りません。言語によって、明示する情報と文脈に委ねる情報が異なるためです。自然で適切な訳文であっても、そこから原文に含まれる情報をすべて復元できるとは限りません。
そこで、Gemma 4に原文と合成訳文の両方を与え、逆方向の翻訳としても適切な対応となるよう原文を調整します。この際、原文の自然な表現をできるだけ保ちながら、合成訳文との対応がずれた箇所を修正します。逆方向の学習には、こうして構築した「合成訳文 → 修正された原文」のペアを用います。
逆翻訳自体は翻訳モデルの開発において古くから知られているアプローチですが、LLMの発展によって高精度に、かつ大規模に行うことができるようになりました。最終的なデータセットとしては、順方向と逆方向のデータの両方を用いています。
反復的自己蒸留によるデータ改善
「トーナメント式データ合成」「逆翻訳」の仕組みによって、LLMによる合成データで学習しているにも関わらず、PLaMo翻訳モデルは合成元のLLMよりも良い翻訳を出せるモデルとして進化していきます。これによって完成された最新のPLaMo翻訳モデルをうまく使うことで、訳文の品質を更に改善できると考えています。これを反復的自己蒸留と呼んでいます。
反復的自己蒸留によるデータ改善のイメージ図を以下に示します。
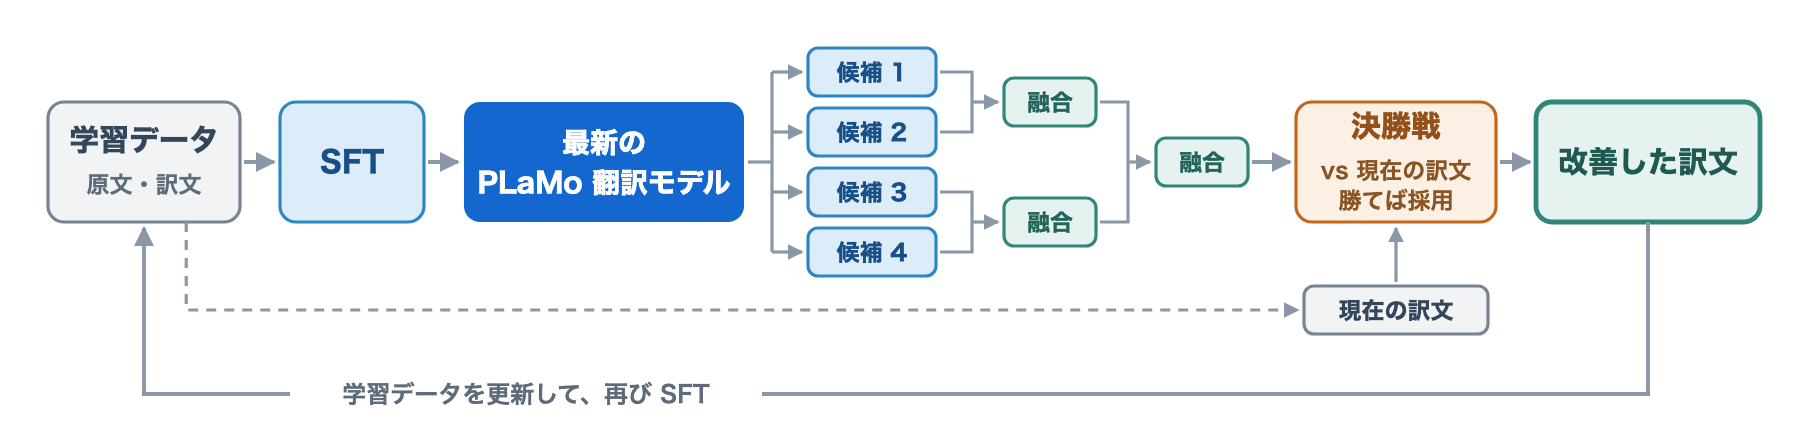
まず、その時点のデータでSFTを行った最新のPLaMo翻訳モデルを用いて、複数の翻訳候補を生成します。次に、トーナメント式データ合成によって、より良い訳文を生成します。最後に、この新しい訳文と現在のデータセットに含まれる訳文を「決勝戦」として比較し、新しい訳文の方が良いと判定された場合に採用します。
これによって改善された学習データを用いて再びSFTを行い、そのモデルを用いてデータを改善する、というサイクルを繰り返しています。計算コストの都合上、この反復的自己蒸留はPhase2 SFTデータのみに適用しています。
最終的なデータセット
最終的に完成したデータセットの量は以下のようになっています。
| Phase1 SFTデータ | 約33.9Bトークン |
| Phase2 SFTデータ | 約3.4Bトークン |
| 合計 | 約37.3Bトークン |
文庫本一冊を10万文字前後とすると、数十万冊に相当する量です。
Phase1 SFTデータは大規模コーパスからのマイニングを中心にして集めた比較的シンプルなデータセットです。とはいえ、Phase1 SFTデータも前述のトーナメント式データ合成と逆翻訳を用いて構成されているため、ペアデータとして相当に高い品質を持っています。
Phase2 SFTデータには、マイニングで集めたデータに加え、SaaSのリクエスト形式に合わせたものなど、より多様で実際のユースケースに近いデータを含めています。トーナメント式データ合成と逆翻訳に加え、反復的自己蒸留によって訳文をさらに洗練しています。Phase2 SFTデータはPhase1と比べると相対的に少量ではありますが、それでも文庫本数万冊レベルの規模に到達しています。
Phase2 SFTデータには、例えば以下のようなカテゴリが含まれています(一部抜粋)。
| 学術論文 | 文学 |
| 技術文書 | 金融 |
| 特許 | 医療 |
| ニュース | 百科事典 |
| Web全般 | イディオム |
| 口語 | 文字起こしテキスト |
| ブラウザ翻訳 | ファイル翻訳 |
分野に多様性を持たせつつ、ブラウザ翻訳、ファイル翻訳のようなSaaSの実ユースケースに合わせたデータを積極的に含めるようにしています。
このような2段階のアプローチにより、まずPhase1 SFTで翻訳タスク自体にモデルを適応させ、多様かつ高品質なPhase2 SFTで翻訳モデルの実用性・品質を更に引き上げることを狙います。
SFT
このようにして構築したデータセットを用いて、ベースモデル(事前学習のみが終わった状態のモデル)に対して2段階のSFT (Supervised Fine-Tuning) を適用します。
SFT適用時点での各モデルの性能は次のようになっています。
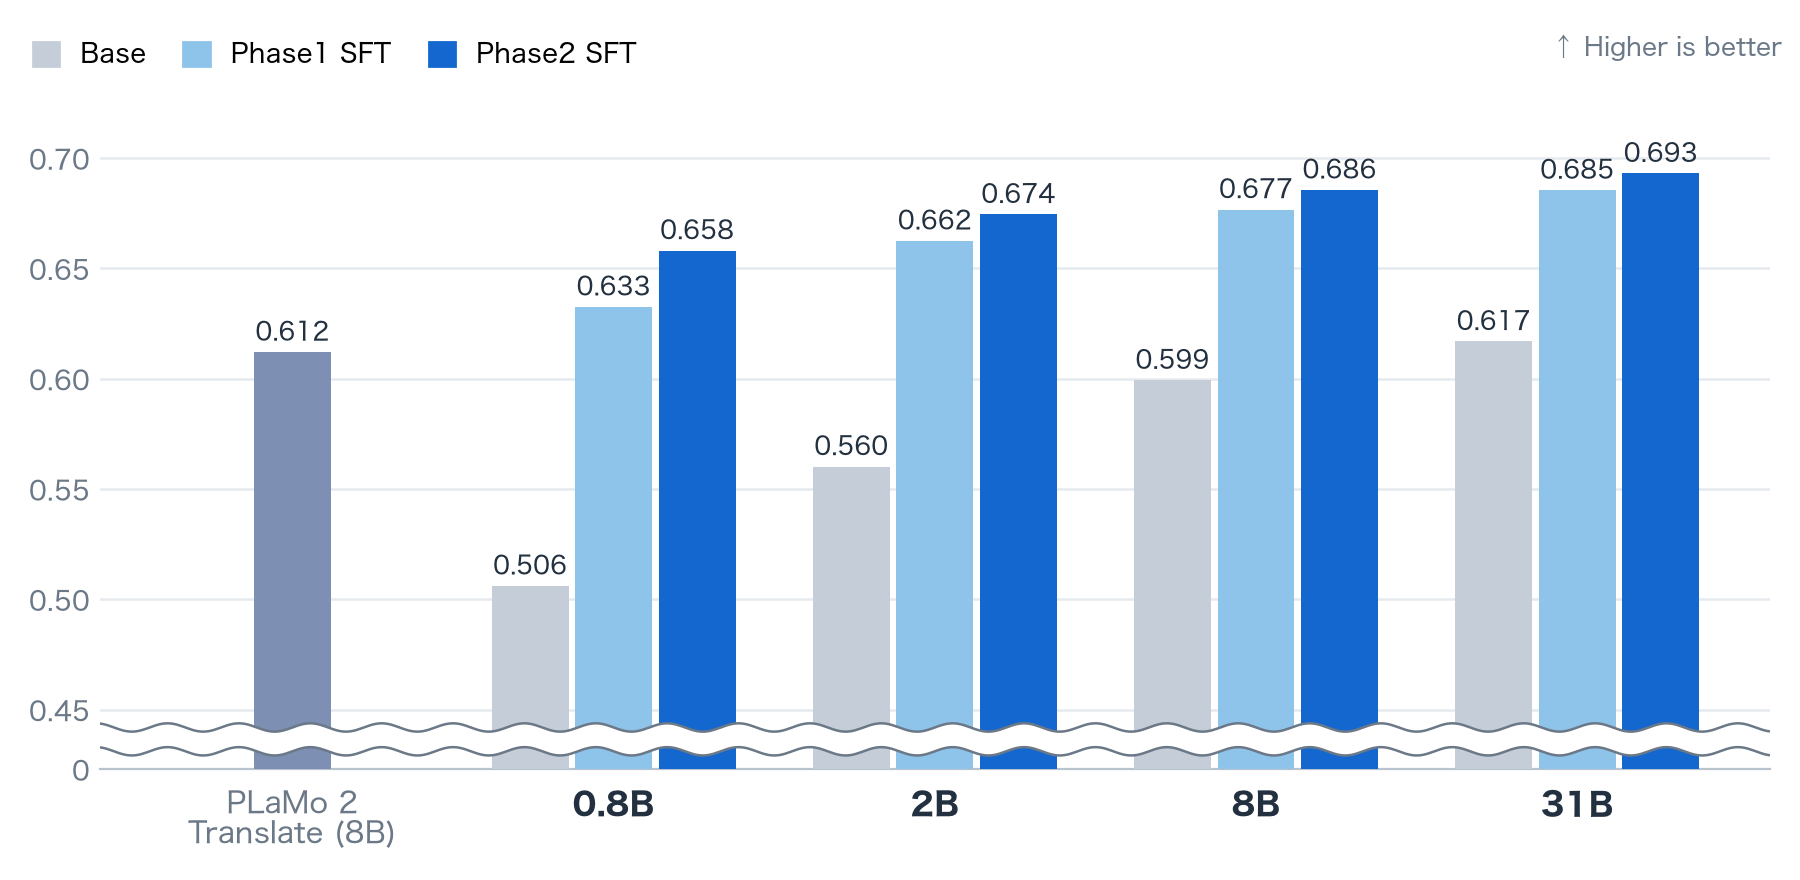
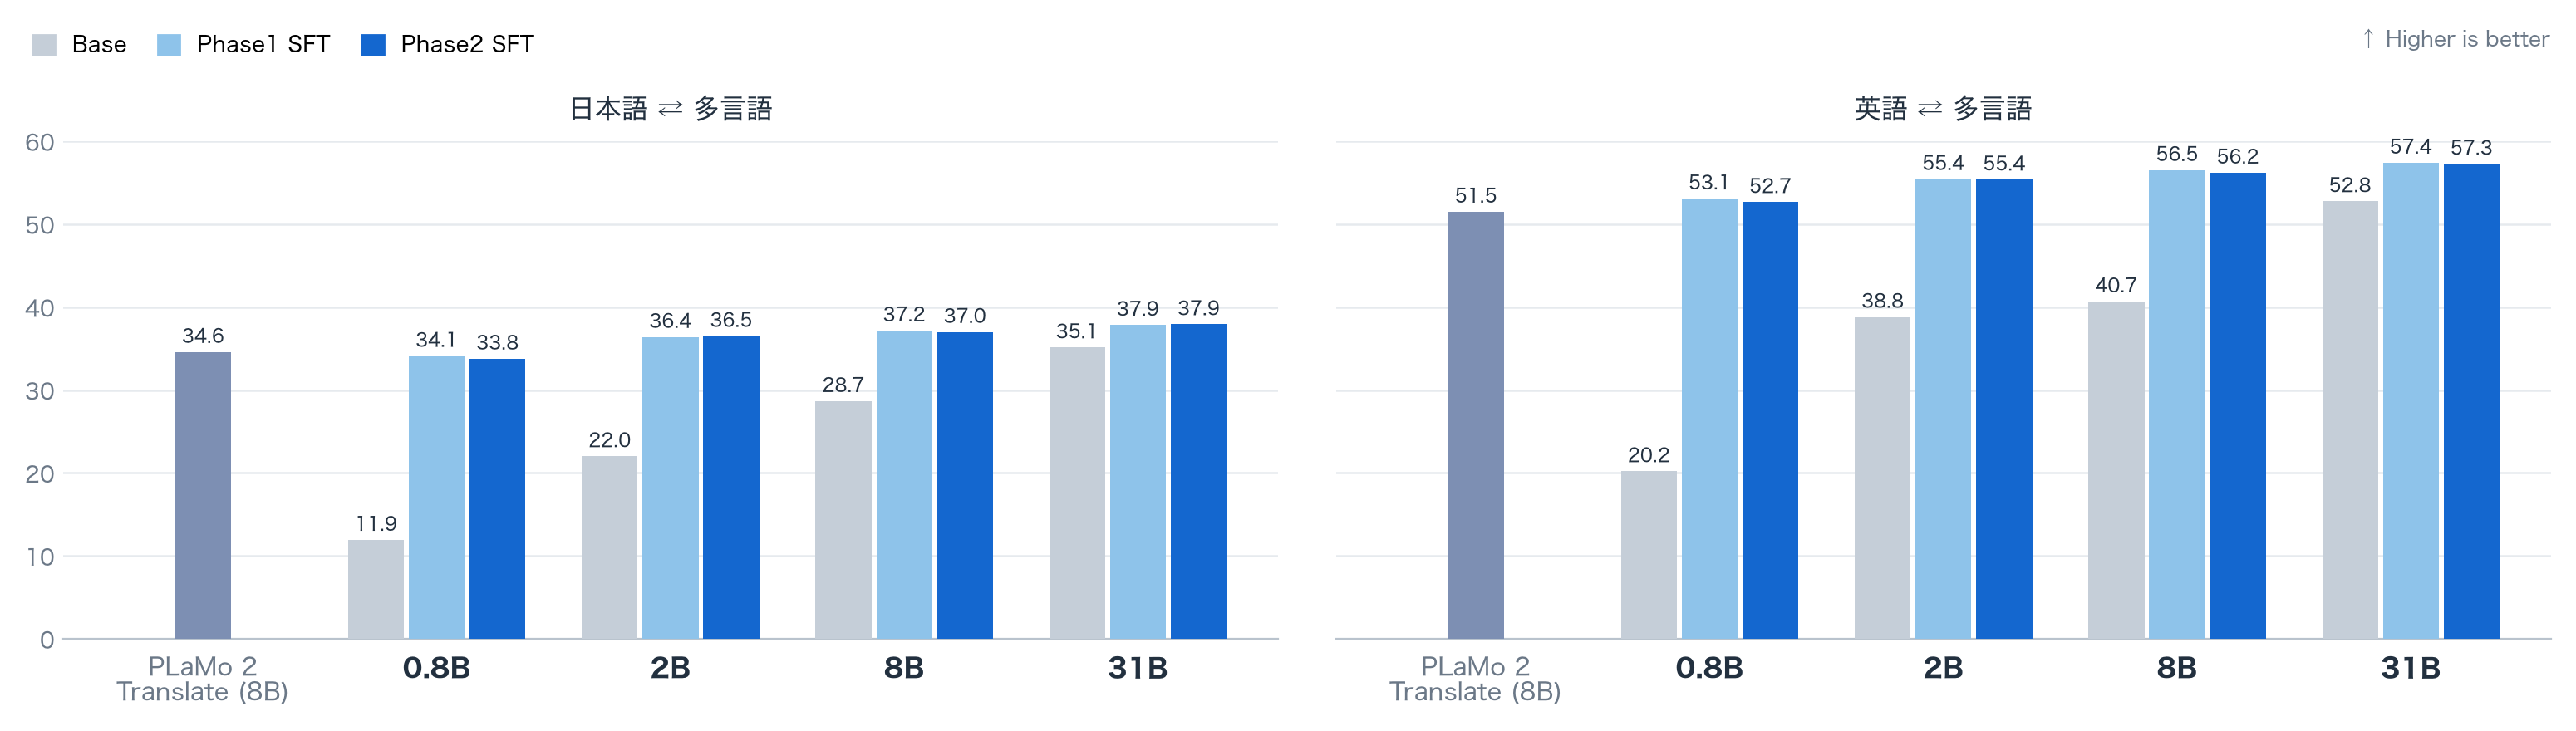
図5に日英性能を示しています。PFTB、SaaS、WMT24++ COMET-22の3ベンチマークのスコアの平均値です。図6には多言語性能を示しています。FLORES+ chrF++を用いて各言語との間の性能を計測したものであり、左が日本語↔多言語の性能、右が英語↔多言語の性能です。スコアのスケールが異なるため、左右の値は比較可能ではないことにご注意ください。
日英性能については、Phase1 SFTの適用によってベースモデルから大きく性能が向上し、更に洗練されたデータによるPhase2 SFTでもう一歩性能が伸びている様子がうかがえます。また、0.8Bモデルでさえも、8BモデルであるPLaMo 2 Translateモデルを上回ることが出来ています。
多言語性能についてはPhase1 SFTとPhase2 SFTでの差はほとんどありませんが、Phase1 SFTによってベースモデルから大きく性能が向上しており、特に小さいモデルでの性能向上が著しい事がわかります。
総合して、データを丁寧に洗練したSFTによって、劇的な翻訳性能の向上が達成できたことがわかります。これは、PLaMo 2 Translateの開発時から大きく変わった点の1つです。PLaMo 2 Translateでは、後段のDPOによる性能向上が顕著でした。一方、PLaMo 3 Translateでは、データを徹底的に洗練することで、SFTだけでも大幅な性能向上を達成しています。
開発期間を通してデータセットの洗練を実施し続けていましたが、学習方式やハイパーパラメータをほとんど変えないままに、データセットの洗練のみでモデルの性能を継続的に向上させることが出来ていました。
DPO
SFTの適用後、更なる翻訳品質の改善のために、DPO (Direct Preference Optimization) を適用しています。DPOでは、(原文、chosen、rejected)のタプルデータを準備します。chosenは原文に対する「良い翻訳」であり、rejectedは原文に対する相対的に「悪い翻訳」になるようにします。
DPOでは、原文を入力したときに、chosenをrejectedに比べて相対的に生成しやすくするよう学習します。(chosen、rejected)はいずれもその時点でのモデルの出力から選んでおり、実際のモデルの出力のうち、好ましくない挙動にペナルティを与えつつ、最後の仕上げ的に翻訳能力を引き上げることが狙いです。
chosen、rejectedの選定方式のイメージを以下に示します。
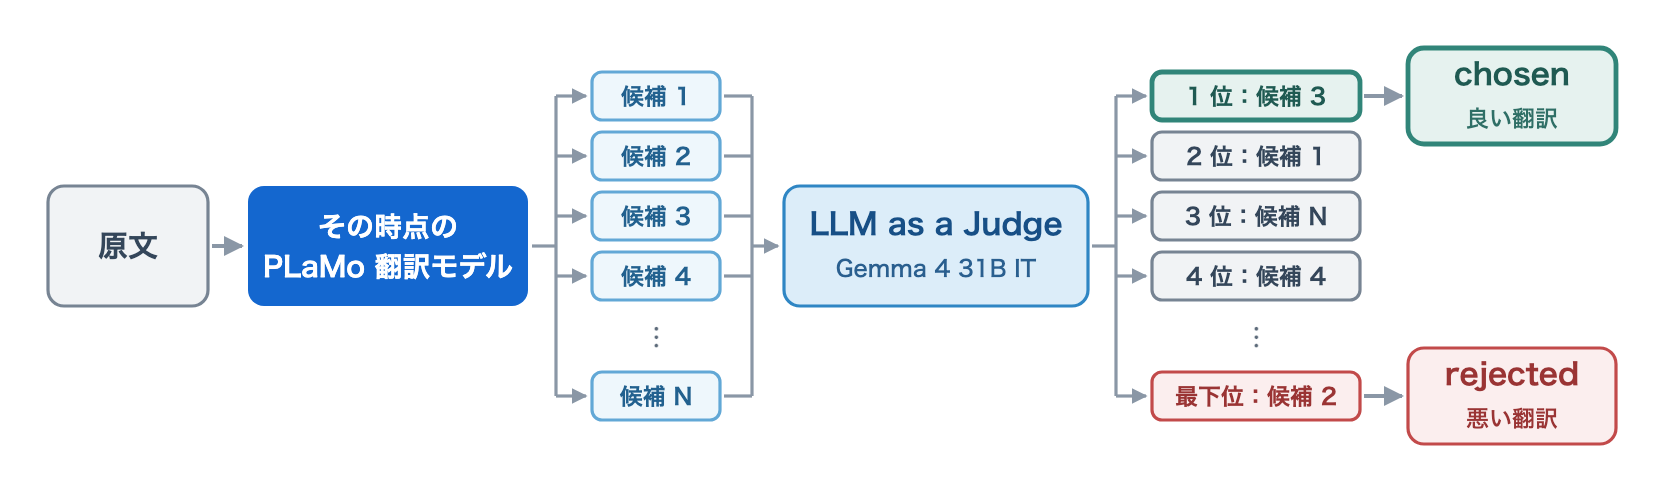
chosen、rejectedの候補となる翻訳をまずその時点のモデルから多数生成します。これに対して、LLM as a Judgeでランキングをつけ、最も良いものをchosenに、悪いものをrejectedにしています。LLM as a Judgeを行うモデルには、データ合成時と同様にGemma 4 31B ITを用いています。
また、DPOは一回ではなく、2段階適用するIterative DPOを実施しています。これは、一度学習が進んだあとのDPOモデルで改めて候補生成、chosen/rejectedの選定、学習を行うことで、更なる性能向上が見込めるためです。
DPOによる性能変化のグラフを次に示します。
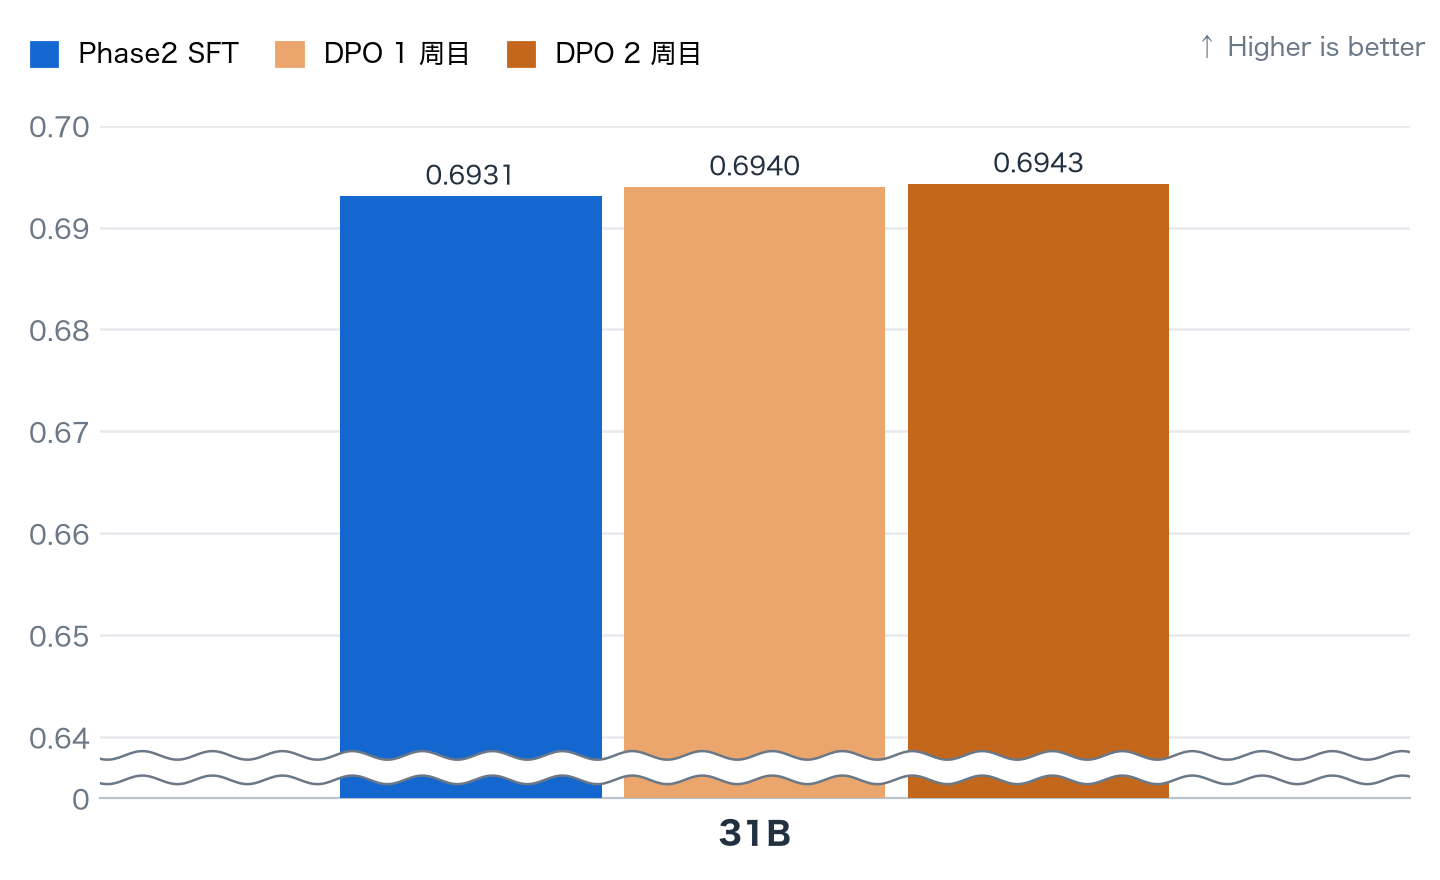
図に示したのはPFTB、SaaS、WMT24++ COMET-22の3ベンチマークの平均です。DPOによる性能向上はベンチマーク上はほとんど計測できないほど小さな差しか確認できません。実際の文章を見ると一定の改善幅が見られるのですが、ベンチマークスコアには現れづらくなっています。
このため、DPOモデルの開発にあたっては、LLM as a Judgeを用いたペアワイズ比較によってより精緻な性能調査を実施しました。
| PFTB 英 → 日 | PFTB 日 → 英 | |
| SFT vs DPO 1周目 (DPO 1周目の勝率) | 57% | 59% |
| DPO 1周目 vs DPO 2周目 (DPO 2周目の勝率) | 53% | 57% |
各サンプルについて、Gemini 3.1 Proが二つの訳文の提示順を入れ替えて2回判定しました。判定が割れた場合は双方に0.5勝としています。互角の場合は勝率が50%になります。これを見ると、DPOを重ねるにつれて、ごく僅かではありますが性能を向上できていることがわかります。
以下は、PFTBの英→日翻訳から選んだ2例です。31BモデルのPhase2 SFT後と、DPOを2周適用した公開モデル PLaMo 3 Translate 31B を比較しています。入力と生成設定は同一で、原文とモデル出力から該当箇所をそのまま抜粋しています。
ハイライトの見方:黄色がSFTの表現、緑がDPO後の対応する表現です。以下の説明で取り上げる箇所に色を付けています。
例1
アクセサリー店の店主が、開店までの苦労とお客様の反応を振り返る文章です。
| 原文(英語) | 31B SFT (Phase2) | PLaMo 3 Translate 31B (DPO2周目) |
|---|---|---|
| It was tough at first, but seeing happy customers made it all worth it. | 最初は大変でしたが、お客様に喜んでいただける姿を見て、すべてが報われました。 | 最初は大変でしたが、お客様の喜ぶ姿を目の当たりにし、すべてが報われたと感じました。 |
改善のポイント:「お客様に喜んでいただける姿」という不自然なつながりが、「お客様の喜ぶ姿」に変わっています。喜んでいるのがお客様であり、それを店主が見ているという原文の関係が、より素直に伝わる表現になっています。
例2
医薬品の説明文から、治療上の用途を述べた一文を抜粋しています。
| 原文(英語) | 31B SFT (Phase2) | PLaMo 3 Translate 31B (DPO2周目) |
|---|---|---|
| Adderall is indicated in the treatment of attention deficit hyperactivity disorder (ADHD) and narcolepsy. | アデロールは、注意欠如・多動性障害(ADHD)およびナルコレプシーの治療に適応している。 | アデロールは、注意欠如・多動性障害(ADHD)およびナルコレプシーの治療に適応がある。 |
改善のポイント:ここでの is indicated は、その薬が治療に使われることを表します。「治療に適応している」では、薬が何かに順応しているようにも読めます。DPO後の「治療に適応がある」は、この文脈に合う言い方です。専門用語を含む短い文でも、語のつながりが自然になっています。
DPOによって、常に全ての表現が改善されるわけではないのですが、今回示した例のように、流暢性を向上させようと細かい表現を調整しようとする傾向が伺えます。
余談ですが、開発初期には、DPO以外の方法としてGRPOによる性能向上も検討しました。結論としては、ベンチマークスコアを向上させることは出来ましたが、人手評価で流暢性が下落する傾向が見られたため、不採用となりました。
GRPOの報酬関数としてLLM as a Judgeを用いていましたが、流暢性に関する評価を行うように指定しても、報酬関数の値は向上するものの人手評価の向上に寄与しない傾向が見られました。これは、各言語における流暢性を適切に評価すること自体が難しいためだと考えています。
強化学習は報酬として表現されているものを最大化する力が非常に強いため、他に設定していた、翻訳の忠実性などに関する報酬を高めることに注力した結果、流暢性を犠牲にするような学習が進んでしまったのではないかと推測しています。
DPOでもchosen / rejectedの選定にLLM as a Judgeを用いるため、同じ問題が起こりそうに思えます。今回は、通常のDPO損失に加え、chosenに対するSFT損失や参照モデルとのKL正則化を併用しました。DPO適用前のモデルから離れすぎないよう、これらの正則化の強さを細かく調整しています。こうした調整により、流暢性をむしろ向上できることが分かっています。
蒸留
PLaMo 3 Translate 31BモデルについてはSFT → DPOで完成としていますが、8B以下のモデルについては、31Bという大きなモデルを教師とすることで更に性能を向上するべく、蒸留を実施しています。SFTでは正解の訳文を出すように学習しますが、蒸留では、各トークン位置で教師モデルが予測する「次のトークンの確率分布」を生徒モデルに学習させます。
採用した蒸留の手法は、PFNの2026年夏インターンで活動してくださった品川健太郎さんの成果に基づいて決定しています。その手法に辿り着くまでの実験については後々インターン成果のTech Blogとして公開予定です。ここでは一旦最終的な採用手法についての説明のみを行います。
今回の蒸留手法は、DistiLLM-2 [14] をベースに、学習対象の分布をAMiD [15] を用いて調整したものになります。近年のLLM向け蒸留手法を組み合わせたモダンな手法になっていると考えています。以下に今回の蒸留手法の全体像を示します。
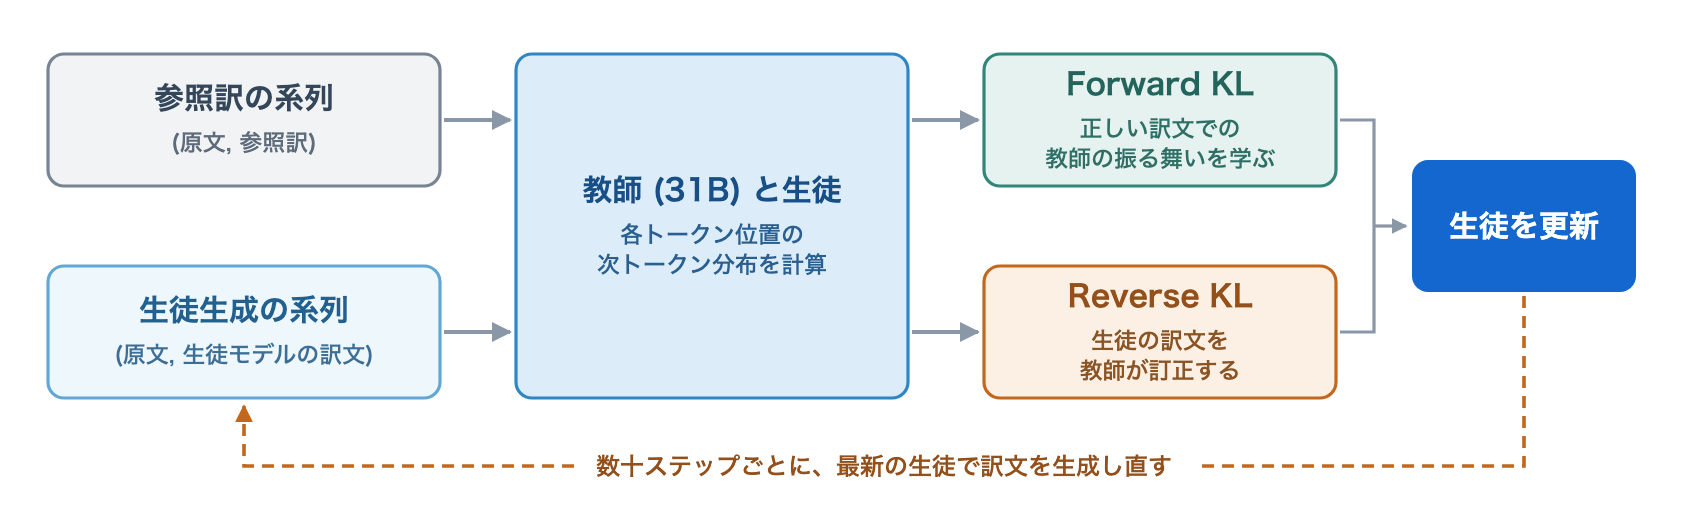
PLaMo 3 Translateの蒸留では、DistiLLM-2に倣い、オフポリシー蒸留とオンポリシー蒸留を組み合わせています。具体的には、教師のトークン分布を学習するために、次の2種類の系列を常に用意しています。
- 参照訳の系列: データセットに含まれる (原文、訳文) のペア。オフポリシー蒸留に相当
- 生徒生成の系列: (原文、学習対象の生徒モデルで温度0で生成した訳文) のペア。オンポリシー蒸留に相当
DistiLLM-2ではオフポリシー側が教師生成の系列になっているので、細部が少し異なりますが、意図としては概ね同じです。
これらの文章において、参照訳の系列では教師モデルとの間のForward KLを、生徒生成の系列では教師モデルとの間のReverse KLを計算し、学習時の損失関数にしています。Forward KL / Reverse KLの細かい説明はここでは省きますが、直感的には、
- Forward KL: 教師の振る舞いを真似るように促す
- Reverse KL: 教師と異なる振る舞いを抑える
というようなイメージです。
全体として、大まかに言えば、参照訳の系列上において、「正しい翻訳が出せている状況における教師の振る舞い」を学び、生徒生成の系列上において、「生徒が出した翻訳分布への教師による訂正」を学んでいるようなイメージです。
学習が進むにつれて生徒モデルが更新されるため、生徒生成の系列は、学習途中に数十ステップ毎に生成し直しています。多少の遅延があるので完全なオンポリシーとは言えませんが、ここの遅延については結果に影響がないことを予備実験により確認しています。
ここまでは通常のKLによる説明ですが、実際にはAMiDの混合分布を用いて損失を調整しています。次の図は、生徒生成の系列のあるトークン位置について、次トークンの確率分布を模式的に描いたイメージ図です。
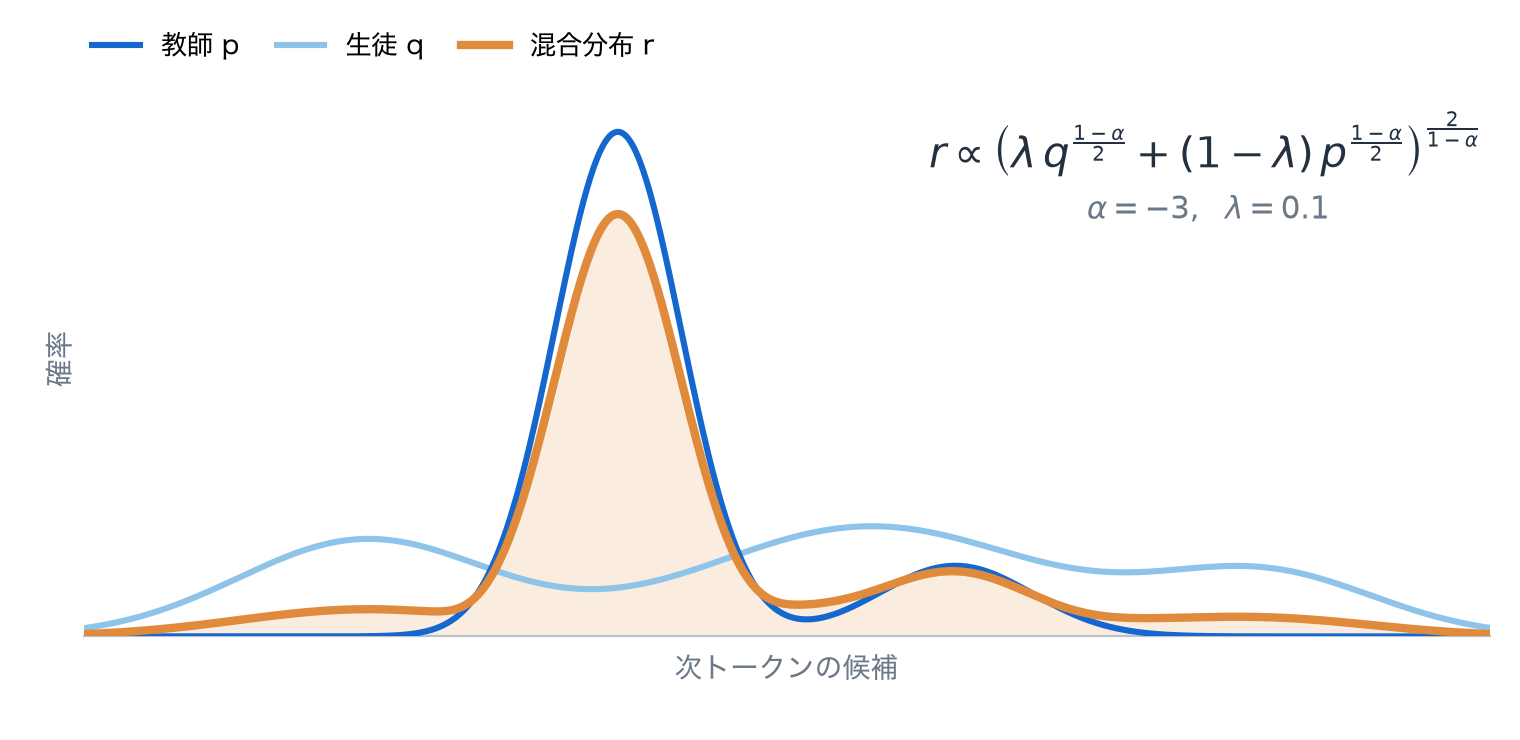
前述したようにReverse KLでは教師と異なる振る舞いにペナルティがかかるため、教師が「ほぼ出現しない」と判断するトークンに生徒が確率を割り当てると、損失が極端に大きくなり、学習が不安定になることがあります。
そこでAMiDでは、教師と生徒の分布を混ぜた分布 r を作り、これを生徒が近づく目標にします。混合割合に加えて、パラメータ α でも分布の混ぜ方を調整できます。
今回の設定では、教師が高い確率を与えるトークンでは、その確率をほぼ保ちます。一方、教師がほぼゼロの確率しか与えないトークンにも、生徒の分布を少し反映します。これにより、教師と異なる予測に対するペナルティーを和らげ、生徒を徐々に教師の分布へ近づく手助けをすることができます。予備実験において、このような工夫を取り込んだ方が学習がスムーズに進むことを確認しています。
図はReverse KLの場合を示しています。Forward KLでも、教師と生徒の役割を入れ替え、同じ形の混合分布を使います。
蒸留を適用した結果の性能変化について、以下の図に示します。
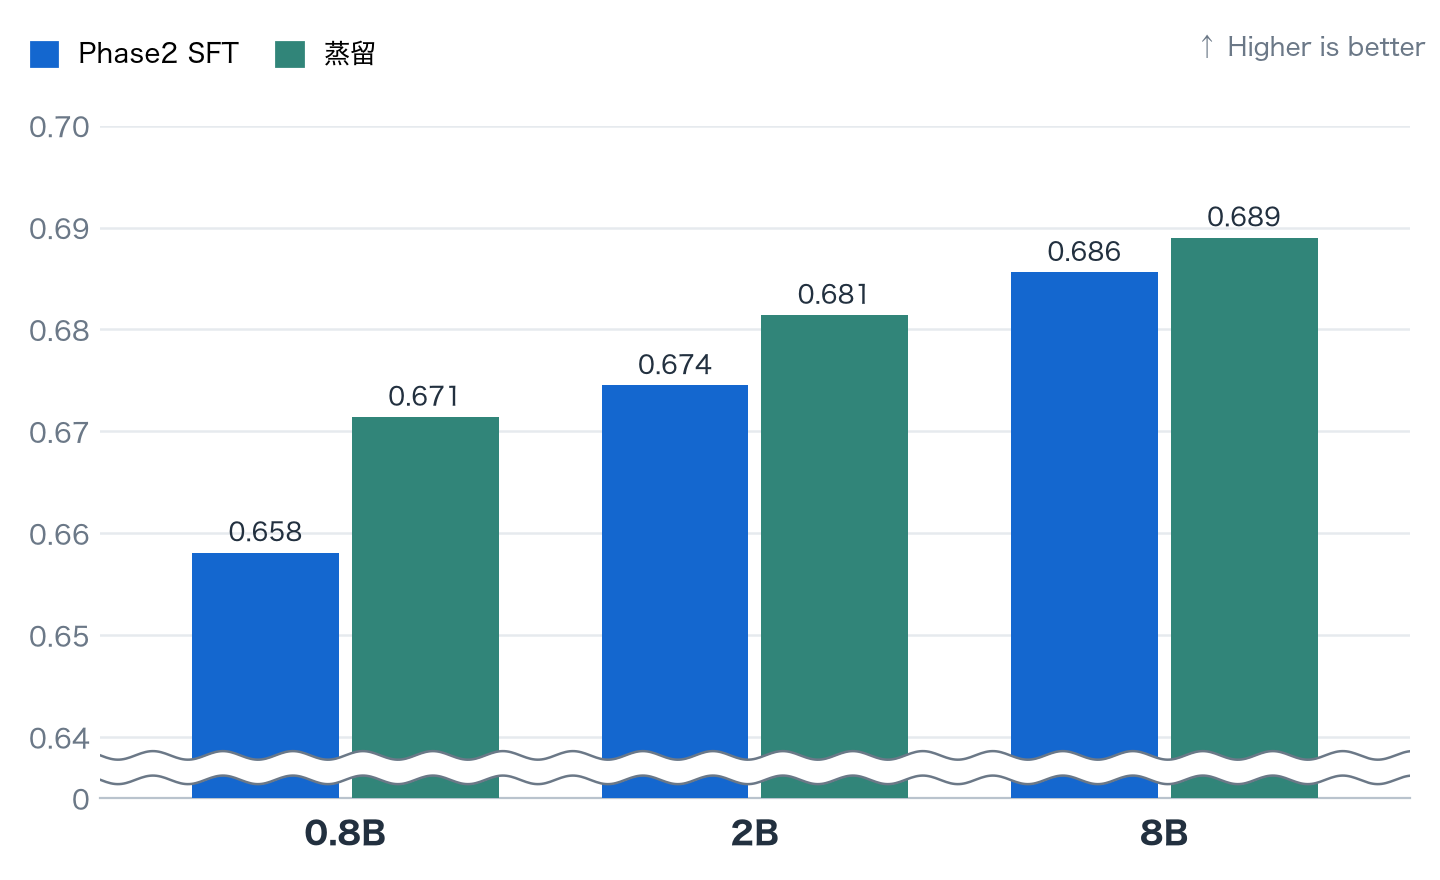
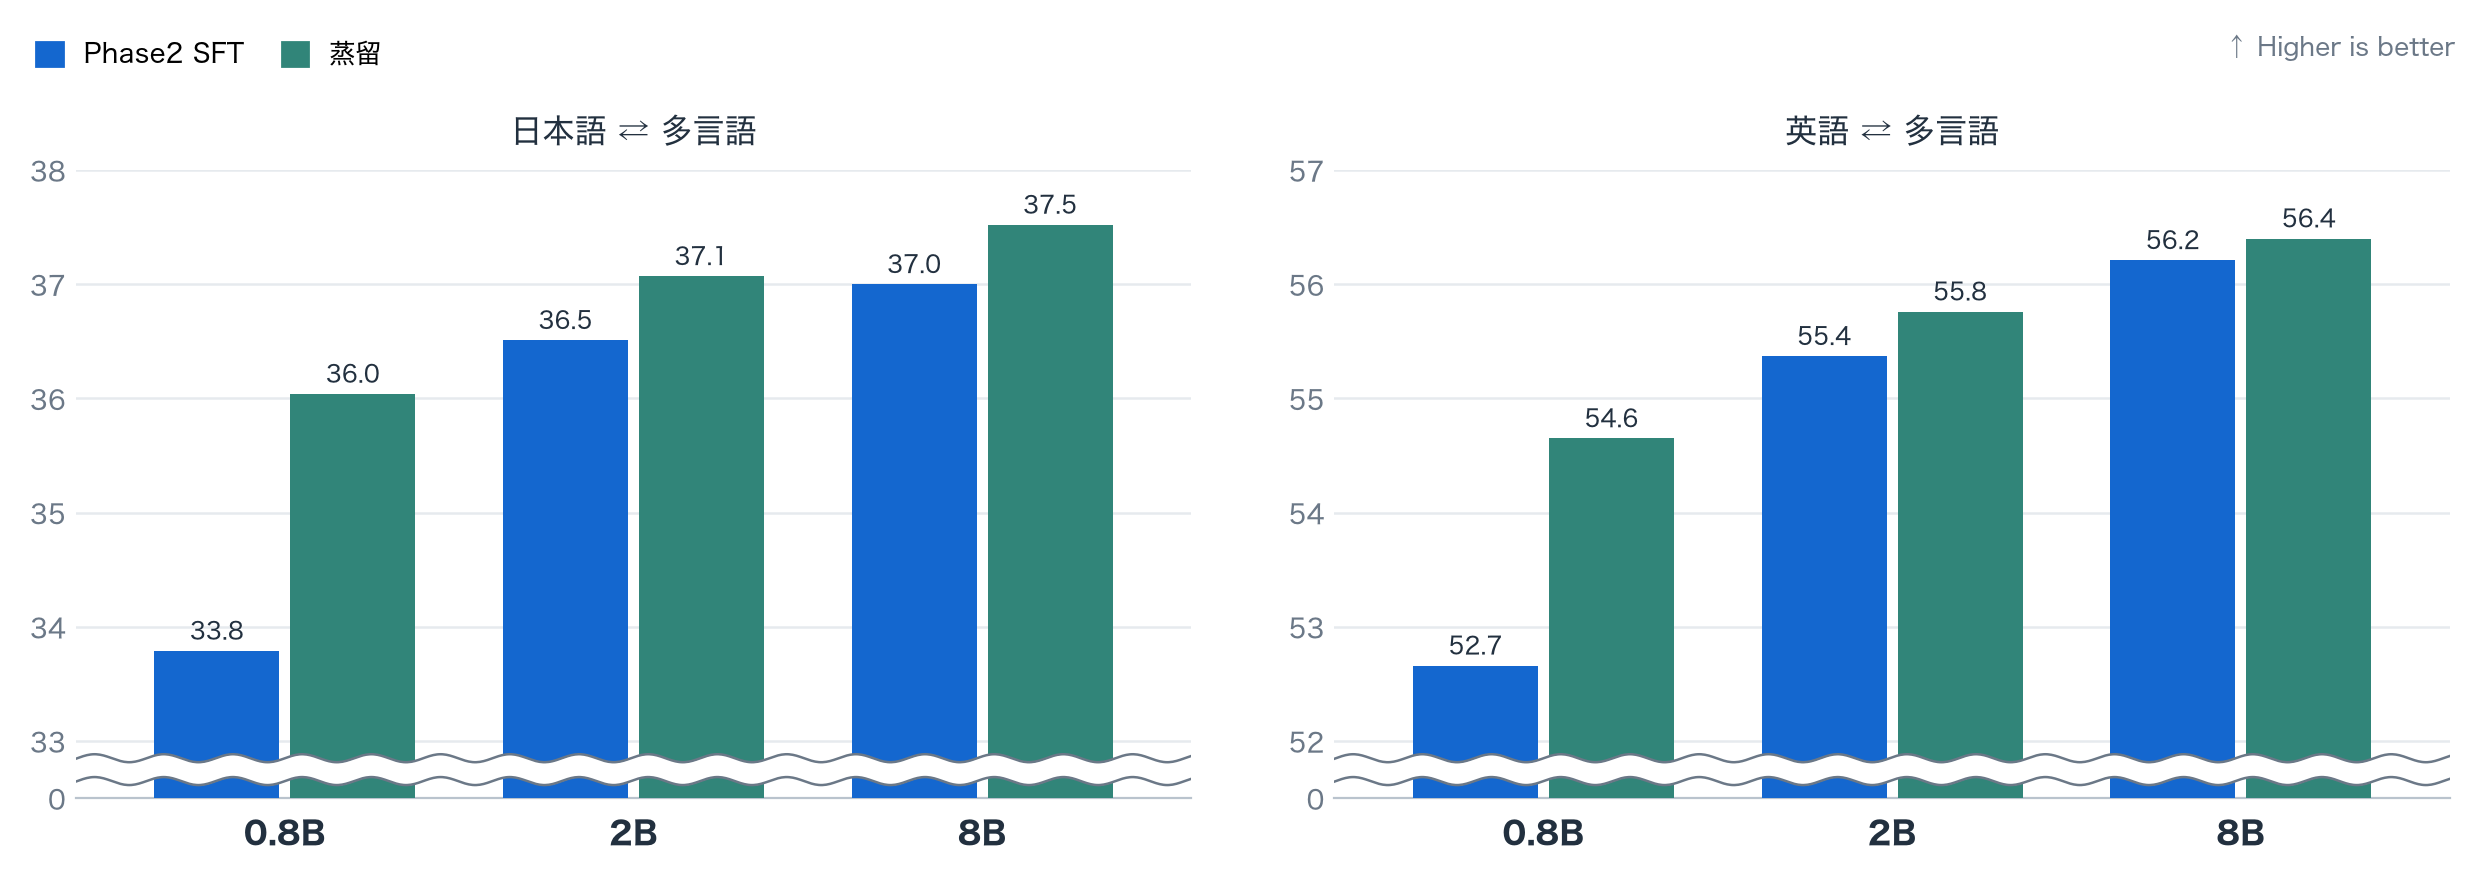
図からも明らかなように、特に小さいモデルで劇的に性能を向上できており、蒸留の効果がうかがえます。一度大きなモデルを構築して、そのモデルの能力を活用して小さなモデルを訓練することに大きな意義があることがわかります。
8B以下のモデルについても、蒸留後には31Bモデルと同様にIterative DPOを適用してモデルを完成させています。
最終的なモデル性能
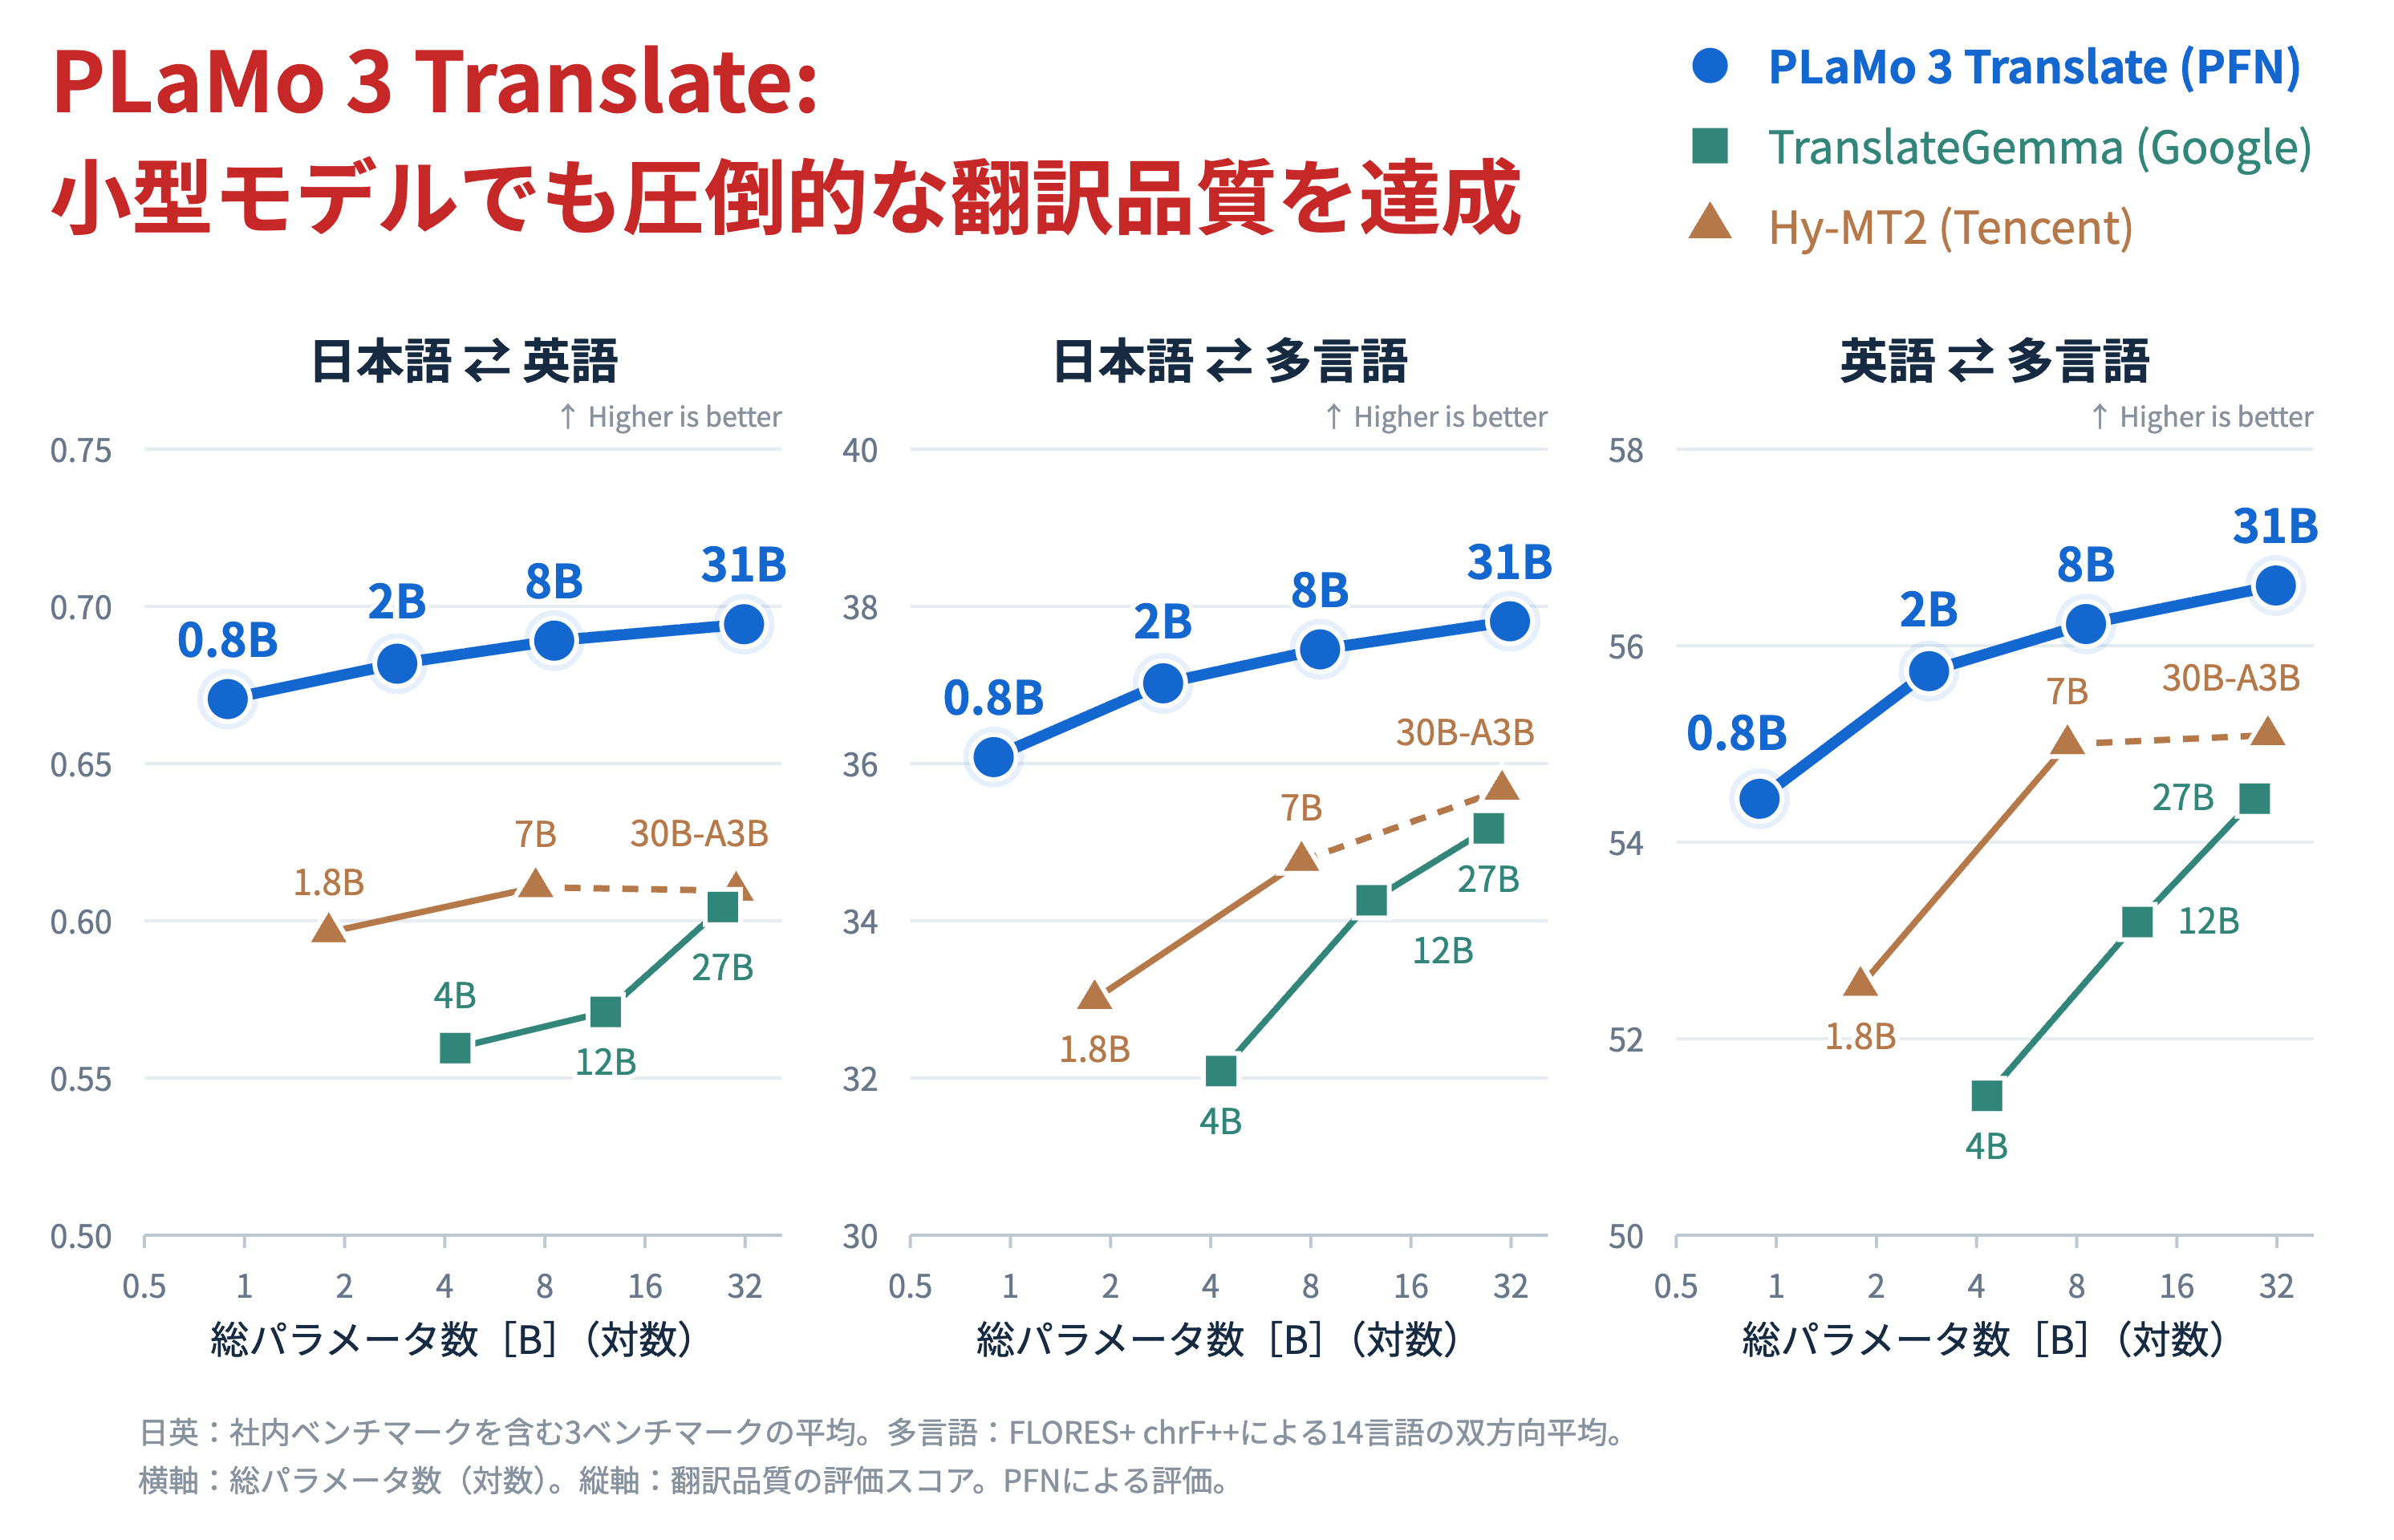
最終的に完成したモデルの性能を以下に示します。
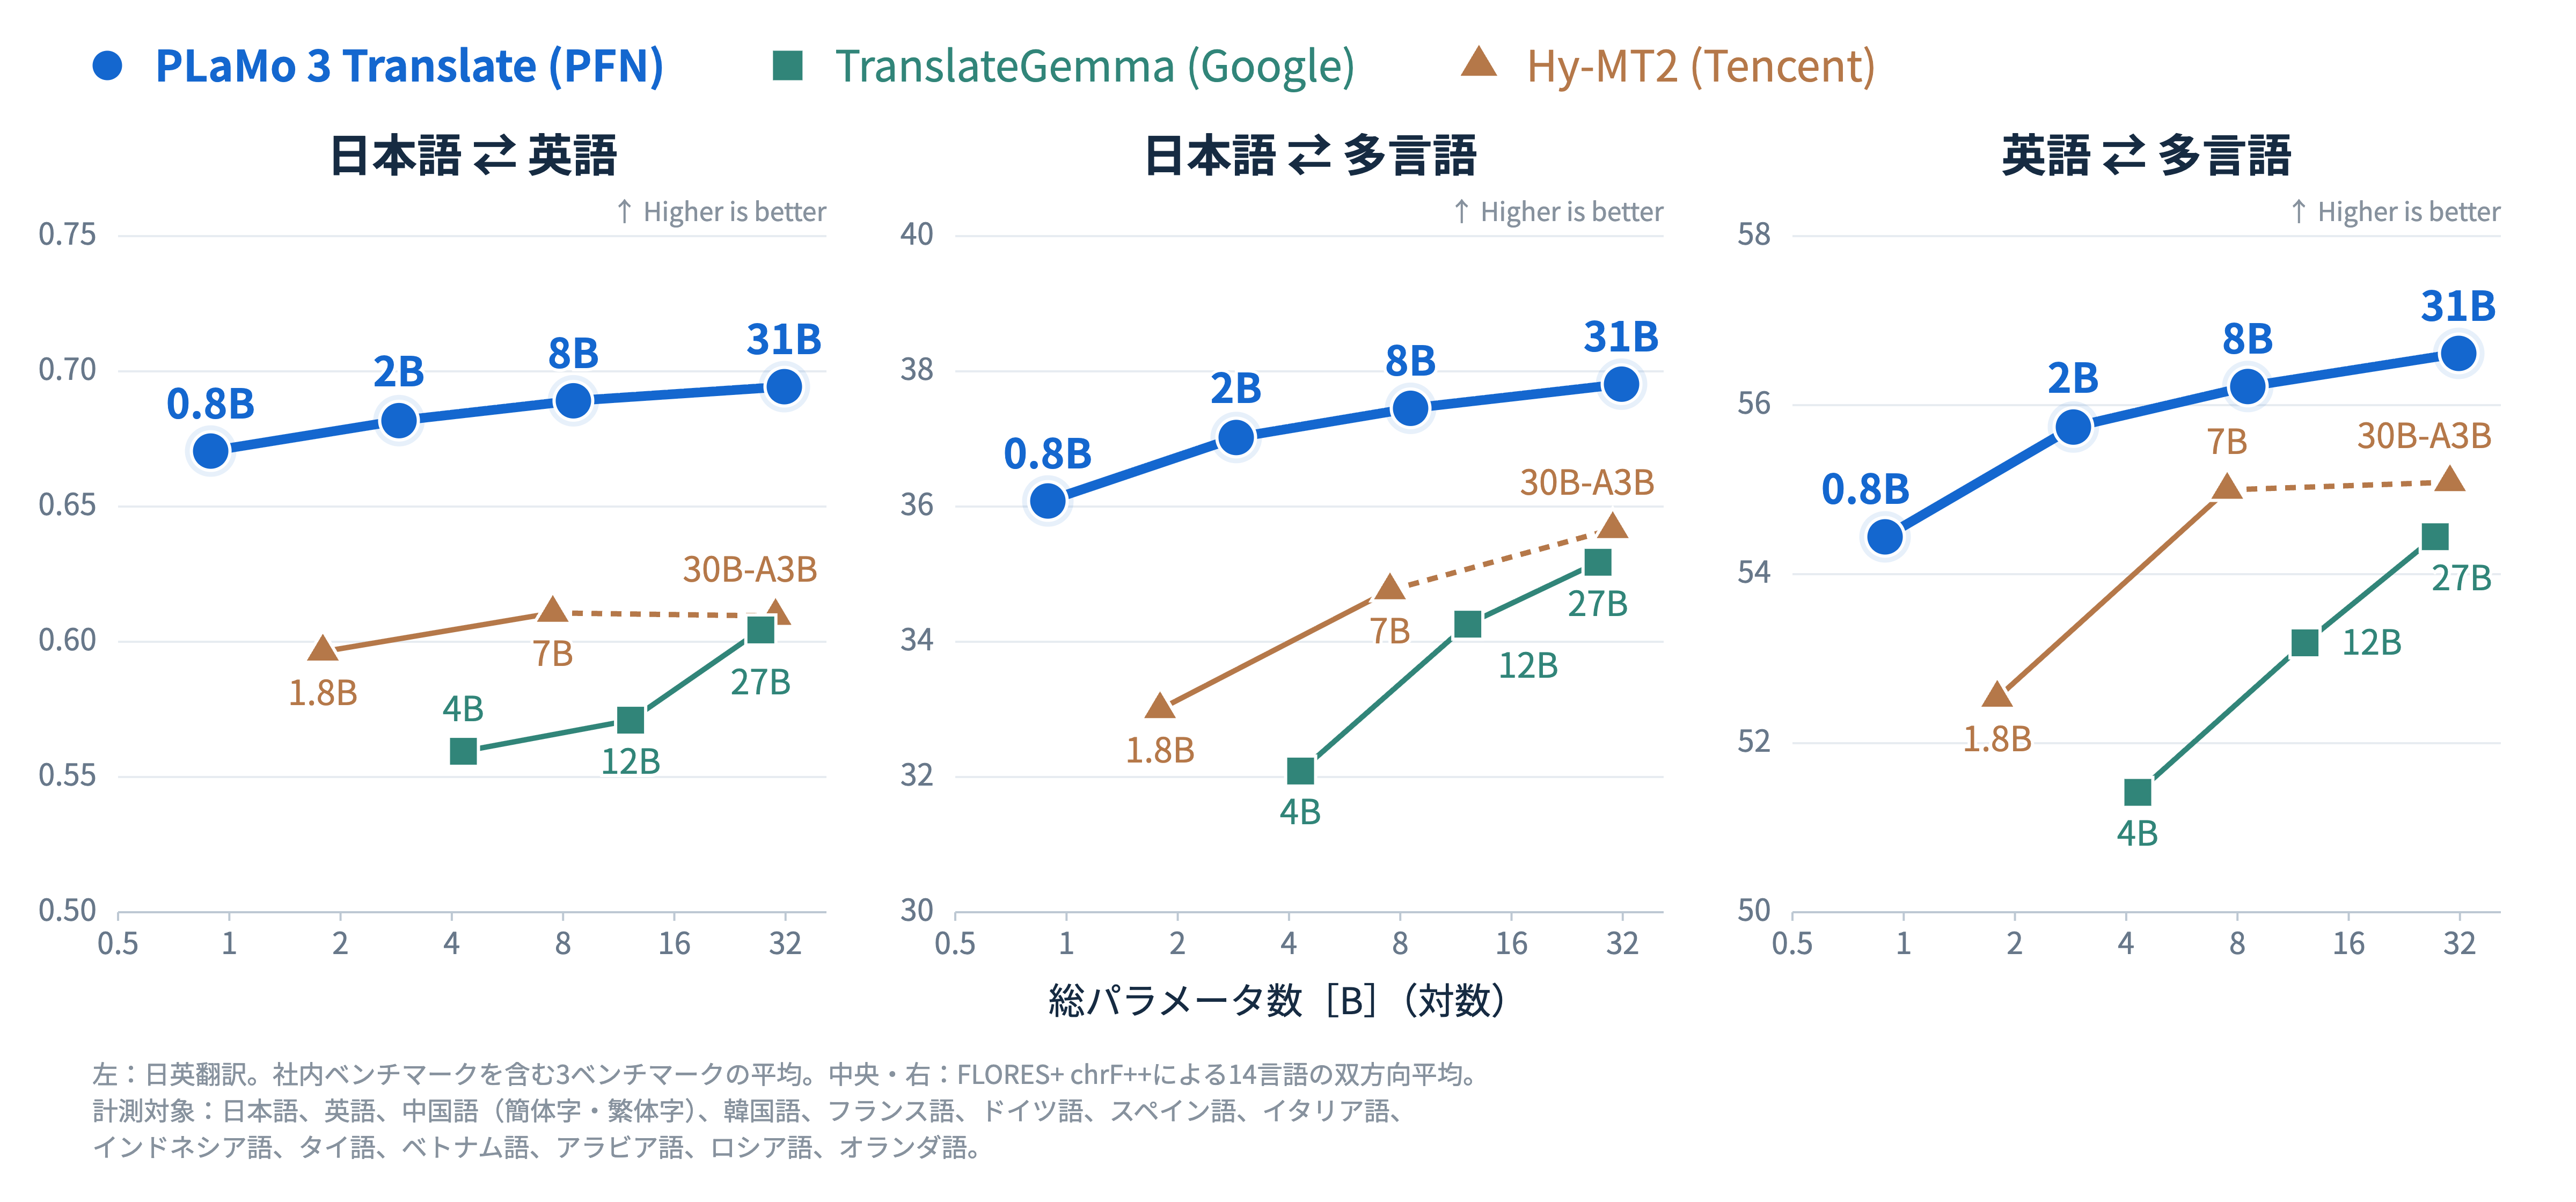
横軸を総パラメータ数、縦軸を性能として描画しています。これまでと同様に、日英性能はPFTB、SaaS、WMT24++ COMET-22の平均を、多言語性能はFLORES+ chrF++の日本語 ↔ 多言語、英語 ↔ 多言語の平均を示しています。
比較対象として、既存の翻訳特化LLMであるTranslateGemma [16] (Google DeepMind)、Hy-MT2 [17] (Tencent)も掲載しています。
全体として、いずれのPLaMo 3 Translateモデルも日英性能、多言語性能ともに既存の翻訳特化LLMを圧倒的に上回る性能を示しています。最小の0.8Bモデルでさえ、日英、日本語↔多言語性能では総パラメータ数が30倍以上大きなものも含めて、既存の全ての翻訳特化LLMを上回る性能を達成しています。英語↔多言語性能においても、2Bモデルの時点で既存の全ての翻訳特化LLMを上回っています。
パラメータサイズが小さくなると流石にやや性能が落ちていく傾向が見られますが、特に日英性能についてはかなり維持できていることがわかります。これは蒸留を活用し、小さいサイズのモデルの性能を最大限高めた成果が現れていると考えています。
総合して、翻訳特化LLMとしてのモデルサイズ - 翻訳性能のパレートフロンティアを劇的に更新し、世界最高の翻訳特化LLMを構築することに成功したと考えています。
まとめ
- 翻訳特化LLM PLaMo 3 Translateのモデル重みをHugging Faceで公開しました。0.8B、2B、8B、31Bの4サイズを公開しており、各種量子化やGGUF・MLX形式でも公開しているので、ぜひ試してみてください。
- PLaMo 3 Translateモデルの開発は、SFT、DPO、小さいモデルにおいては蒸留を用いて行いました。最終的に完成したPLaMo 3 Translateモデルは、最小の0.8Bモデルでさえ、30倍以上大きな既存の翻訳特化LLMを上回る性能を示し、世界最高の翻訳特化LLMと言って良い性能を達成しました。
参考文献
[1] 鈴木海渡(2026). 「plamo-3-translate: フロンティア級の翻訳特化LLM」. Preferred Networks Blog. https://www.preferred.jp/ja/blog/tech/plamo-3-translate-product-release
[2] Cheng, W. et al.(2024). “Optimize Weight Rounding via Signed Gradient Descent for the Quantization of LLMs.” Findings of the Association for Computational Linguistics: EMNLP 2024, pp. 11332–11350. https://doi.org/10.18653/v1/2024.findings-emnlp.662
[3] Kwon, W. et al.(2023). “Efficient Memory Management for Large Language Model Serving with PagedAttention.” Proceedings of the 29th Symposium on Operating Systems Principles (SOSP 2023). https://doi.org/10.1145/3600006.3613165(vLLM: https://github.com/vllm-project/vllm)
[4] ggml-org. llama.cpp. GitHub. https://github.com/ggml-org/llama.cpp
[5] ml-explore. MLX LM. GitHub. https://github.com/ml-explore/mlx-lm
[6] Rafailov, R. et al.(2023). “Direct Preference Optimization: Your Language Model is Secretly a Reward Model.” Advances in Neural Information Processing Systems 36 (NeurIPS 2023). https://papers.neurips.cc/paper_files/paper/2023/hash/a85b405ed65c6477a4fe8302b5e06ce7-Abstract-Conference.html
[7] Deutsch, D. et al.(2025). “WMT24++: Expanding the Language Coverage of WMT24 to 55 Languages & Dialects.” Findings of the Association for Computational Linguistics: ACL 2025, pp. 12257–12284. https://doi.org/10.18653/v1/2025.findings-acl.634
[8] Open Language Data Initiative. FLORES+. Hugging Face. https://huggingface.co/datasets/openlanguagedata/flores_plus(基盤データセットの論文:NLLB Team(2024). “Scaling neural machine translation to 200 languages.” Nature 630, pp. 841–846. https://doi.org/10.1038/s41586-024-07335-x)
[9] 今城健太郎・平野正徳(2026). 「高精度翻訳モデルのための自動評価手法の検討」. 言語処理学会第32回年次大会 発表論文集, pp. 3623–3628. https://www.anlp.jp/proceedings/annual_meeting/2026/pdf_dir/C8-1.pdf
[10] 今城健太郎(2026). 「charsim: パラメータに左右されにくい文字n-gram類似度」. https://imoz.jp/scraps/202607_charsim.html
[11] Rei, R. et al.(2022). “COMET-22: Unbabel-IST 2022 Submission for the Metrics Shared Task.” Proceedings of the Seventh Conference on Machine Translation (WMT), pp. 578–585. https://doi.org/10.18653/v1/2022.wmt-1.52
[12] Popović, M.(2017). “chrF++: words helping character n-grams.” Proceedings of the Second Conference on Machine Translation, pp. 612–618. https://doi.org/10.18653/v1/W17-4770
[13] Gemma Team(2026). “Gemma 4 Technical Report.” arXiv:2607.02770. https://arxiv.org/abs/2607.02770
[14] Ko, J. et al.(2025). “DistiLLM-2: A Contrastive Approach Boosts the Distillation of LLMs.” Proceedings of the 42nd International Conference on Machine Learning (ICML 2025), PMLR 267, pp. 31044–31062. https://proceedings.mlr.press/v267/ko25a.html
[15] Shin, D. et al.(2026). “AMiD: Knowledge Distillation for LLMs with α-mixture Assistant Distribution.” The Fourteenth International Conference on Learning Representations (ICLR 2026). https://proceedings.iclr.cc/paper_files/paper/2026/file/54a468d19bc5727800096d9c7c51a423-Paper-Conference.pdf
[16] Finkelstein, M. et al.(2026). “TranslateGemma Technical Report.” arXiv:2601.09012. https://arxiv.org/abs/2601.09012
[17] Tencent Hunyuan Team(2026). “Hy-MT2: A Family of Fast, Efficient and Powerful Multilingual Translation Models in the Wild.” arXiv:2605.22064. https://arxiv.org/abs/2605.22064
*1 PLaMo翻訳のLLMは、PFNと国立研究開発法人情報通信研究機構(NICT(エヌアイシーティー))の共同研究で得られた事前学習モデル「PLaMo 3 NICT」を基盤として、PFNが開発した翻訳特化型モデルです。
*2 性能計測に用いた言語は少し絞っていますが、PLaMo 3 Translate自体は追加で以下の言語についても学習を実施しています。また、日本語と他の言語の間だけではなく、多言語同士の翻訳の学習も実施しています。
ハンガリー語・ポーランド語・ヒンディー語・ペルシア語・ベンガル語・タガログ語・ヘブライ語・タミル語・ビルマ語・ウルドゥー語・マレー語・ネパール語・カタルーニャ語・マラヤーラム語・ブルガリア語・セルビア語・クロアチア語・スロバキア語・スロベニア語・シンハラ語・アゼルバイジャン語・ジョージア語・アルメニア語・ウズベク語・リトアニア語・クメール語・ラトビア語・エストニア語・バスク語・セブアノ語・ベラルーシ語・テルグ語・ジャワ語・カザフ語・マラーティー語・スワヒリ語・グジャラート語・パンジャブ語