本記事は、2026年度のPFN夏季インターンシップに参加した東北大学修士1年の大原考道さんによる寄稿です。
背景と目的
機械翻訳の品質が向上するにつれて、高精度なモデル同士の性能差を評価することは難しくなっています。近年は、MetricX[1]などの学習済みモデルを用いて品質を推定する指標や、事後学習済みLLMに訳の優劣を直接判定させるLLM-as-a-Judgeのように、大規模なモデルを用いる評価手法が主流になりつつあります。両者に共通する課題は、評価のたびに大規模なモデルの推論が必要になり、計算コストがかかることです。LLM-as-a-Judgeでは、モデルに加えてプロンプトも評価条件になります[2]。また、利用するモデルやAPIによっては、更新・提供終了・出力の変動などにより、同一条件での再評価が保証されない場合もあります。
この課題に対し、LLMで多数の参照訳を生成し、文字 n-gram に基づく表層マッチング型指標と組み合わせる評価手法が考えられます[2]。同論文では、文字 n-gram に基づく指標に高品質な参照訳を用いることで、既存のモデルベース指標を上回る評価性能が得られると報告されています。
ただし、高品質な参照訳を人手で用意する際には2つの問題があります。第一はコストです。人手による翻訳と校閲には多くの費用がかかるため、原文1件に対して多数の参照訳を用意することは困難です。第二はバイアスです。妥当な訳には、語順や訳語、文体の選択などによって多くの表現があるため、参照訳が1件のみの場合、参照訳と表層的に異なる正当な訳が低く評価されます。
同論文では、ベースモデルから多数の翻訳候補をサンプリングし、フィルタリングを経て参照訳群として用いる方法も検討されています。ただし、参照訳の生成・選別に要するコストやバイアスの分析は今後の課題とされています。
そこで本記事では、表層マッチング指標であるcharsim[3]と、LLMを用いて自動生成した参照訳を組み合わせた翻訳評価指標について、以下を検討します。
- 参照訳の作成元によって評価順位がどう変わるか。特定のモデルが生成した参照訳を用いた場合と、複数モデルの参照訳を混合した場合について、LLM-as-a-Judgeによる基準順位との違いを比較します。
- 高性能な事後学習済みLLMが自動生成した参照訳で、どの程度の評価性能が得られるか。生成した訳を品質による選別なしでそのまま参照訳として用いた場合と、人手による推敲を経て作成された高品質な参照訳を用いた場合を比較します。
- 参照訳の生成に用いるモデルを増やすことで、評価性能を向上させられるか。複数モデルの参照訳を混合したときの評価性能の変化を確認します。
実験概要
翻訳評価データセット
英日・日英の 2 方向について、評価用の原文をそれぞれ 50 件用意しました。各原文には対となる高品質な参照訳が 1 件ずつ用意されており、これは複数の LLM と人手による推敲を経て作成されたものです。以下に例を示します。
- 英日
- source
- Maintaining fluent and coherent translation in long texts remains a central challenge for contemporary neural machine translation (NMT) systems. While existing models achieve strong adequacy on short sentences, they frequently exhibit stylistic inconsistency and discourse discontinuity over extended contexts. This study introduces a hierarchical fluency modeling framework that explicitly separates local and global fluency within a unified architecture. The proposed two-tier decoder captures token-level grammaticality through local decoding and enforces cross-sentence stylistic and discourse consistency via global decoding. Training is guided by a multi-scale fluency objective integrating local language-model regularization, inter-sentence coherence constraints, and style-consistency loss. Empirical evaluations on TED Talks and WMT News Commentary datasets demonstrate substantial fluency improvements for long inputs, achieving up to +1.8 BLEU and +0.7 COMET over strong baselines. Human assessments further confirm enhanced readability and cohesion, underscoring the importance of multi-scale fluency modeling for document-level translation.
- target
- 長文における流暢かつ一貫した翻訳の維持は、現代のニューラル機械翻訳(NMT)システムにおける中心的な課題であり続けている。既存のモデルは短文に対して高い適切性を達成する一方、長い文脈においては文体の不整合や談話の不連続が頻繁に生じる。本研究では、局所的流暢性と大域的流暢性を統一アーキテクチャ内で明示的に分離する階層的流暢性モデリングフレームワークを提案する。提案する二層デコーダは、局所デコードによりトークンレベルの文法性を捉え、大域デコードにより文間の文体および談話の一貫性を確保する。学習は、局所言語モデル正則化、文間一貫性制約、および文体一貫性損失を統合したマルチスケール流暢性目的関数によって導かれる。TED TalksおよびWMT News Commentaryデータセットにおける実証評価により、長文入力に対する大幅な流暢性の向上が示され、強力なベースラインに対して最大でBLEU +1.8、COMET +0.7を達成した。人手評価においても可読性および結束性の向上がさらに確認され、文書レベル翻訳におけるマルチスケール流暢性モデリングの重要性が裏付けられた。
- source
- 日英
- source
- 一態様に係る情報処理装置は、ニューラルネットワークを構成する各層のフォワード処理を定義したコードを含むソースコードを取得する取得手段と、各フォワード処理と該フォワード処理に対応するバックワード処理との対応関係を記憶する記憶手段と、前記ソースコードに含まれた各コードを順次実行する実行手段であって、各コードを実行した時点において、該コードにより定義されたフォワード処理の出力値を入力値に基づいて計算し、かつ、前記記憶手段に記憶された前記対応関係に基づいて該コードに対応する層におけるバックワード処理のための参照構造を生成する、ように構成された実行手段と、を具備するものである。(出典:特許第7418511号公報)
- target
- An information processing apparatus according to one aspect comprises: acquisition means for acquiring source code including code defining forward processing of each layer constituting a neural network; storage means for storing a correspondence relationship between each forward processing and backward processing corresponding to said forward processing; and execution means for sequentially executing each code included in said source code, the execution means being configured to, at the time of execution of each code, calculate an output value of the forward processing defined by said code on the basis of an input value, and generate a reference structure for backward processing in a layer corresponding to said code on the basis of said correspondence relationship stored in said storage means.
- source
LLM-as-a-Judgeを用いた正解データの構築
評価指標を比較する基準として、事後学習済みの LLM を評価モデルとし、全対比較によって基準順位を作成しました。以下ではこれを便宜上「正解データ」と呼びますが、人手による品質順位ではなく、使用したJudgeの評価傾向を含む基準です。
被評価システムには先行研究[2]と同じモデル群を用いました。参照訳生成モデルのM1~M10と被評価システムのA1~A10という2つのグループ内で、原文と 2 つの翻訳候補をLLMに提示し、どちらが優れているかを選択させました。提示順の影響を緩和するため、各組について提示順を入れ替えた 2 通りの比較を行いました。評価モデルには deepseek-v4-flash-0731 と gemma-4-31b-it の 2 モデルを用い、両者の判定を合算しました。原文ごとのシステムのスコアには、グループ内の他システムとの比較における勝率を用いました。
モデルIDや生成・判定プロンプトなどの詳細は本稿に含めていないため、本文と図表だけでは同一条件で実験を再現できません。
本実験では、各手法による被評価システムの順位と正解データの順位との Spearman 相関を、評価性能として用います。相関は以下の2つのレベルで求めます。
- idレベル: 原文ごとの順位のSpearman相関を求め、50件の原文で平均したもの
- システムレベル: 50件全体での平均順位のSpearman相関
提案手法
本実験では、事後学習済みLLMで候補訳を複数生成し、参照訳群として用います。charsimの類似度スコアを計算して被評価システムを順位付けし、Judgeによる基準順位との一致度を調べます。比較対象には、高品質な単一の参照訳を用いたcharsimと、参照訳を使用しないMetricX-24 QEを用います。
- 参照訳の生成: 参照訳の候補を10個の事後学習済みLLMで作成しました。それぞれのモデルをM1~M10とします。各モデルから、原文あたり10件ずつ訳文をサンプリングしました。生成した訳は品質による選別を行わず、そのまま参照訳として用いました。
- 被評価システム: 評価対象のシステムを10個用意しました。それぞれのモデルをA1~A10とします。番号は英日のJudge基準順位に従い、日英でも同じラベルを用います。
- charsim: charsimは文字 n-gram の一致に基づく類似度であり、定義は記事[3]に従います。候補訳 \(t\) と参照訳集合 \(R = \{r_1, \ldots, r_m\}\) に対し、各文字列を境界記号で囲んだ
^+ 文字列 +$から \(1 \le n \le N\) の文字 n-gram を抽出し、境界記号だけからなるn-gramは除外します。文字はUnicodeコードポイント単位で扱い、各n-gramの一致数には候補訳と参照訳の出現回数の小さい方を用います。各 n-gram に重み \(1/n\) を付与します。
平均長版のcharsimを用います。参照訳ごとの重み付き一致量を \(M_i\)、候補訳の重み付き長さを \(L_t\)、参照訳の重み付き長さを \(L_i\) とすると、次の式でスコアを求めます。
分母には候補長と平均参照長の大きい方を使います。この式で得られるスコアは、平均一致量と平均参照長から求めたprecisionとrecallの小さい方に相当します。参照訳が複数ある場合、1件の参照訳だけとよく一致してもスコアは上昇しにくく、多くの参照訳と共通する部分ほど評価に寄与します。次数の上限は \(N=\min(\max(|t|,\max_i |r_i|)+2,32)\) とします[3]。
結果
参照訳生成に使用するモデル間の合意度
図1は、参照訳の生成に使うモデルを変えたとき、評価結果がどの程度一致するかを示しています。各モデルが生成した参照訳だけを用いて評価し、参照訳生成モデルの各ペアについて、評価結果の Spearman 相関を測定しています。
縦軸と横軸は参照訳の生成に使ったモデルを表します。セルの値は、両モデルの参照訳をそれぞれ用いた評価順位のSpearman相関です。上段は原文内順位の平均から求めた相関、下段は原文ごとの相関の平均を示します。
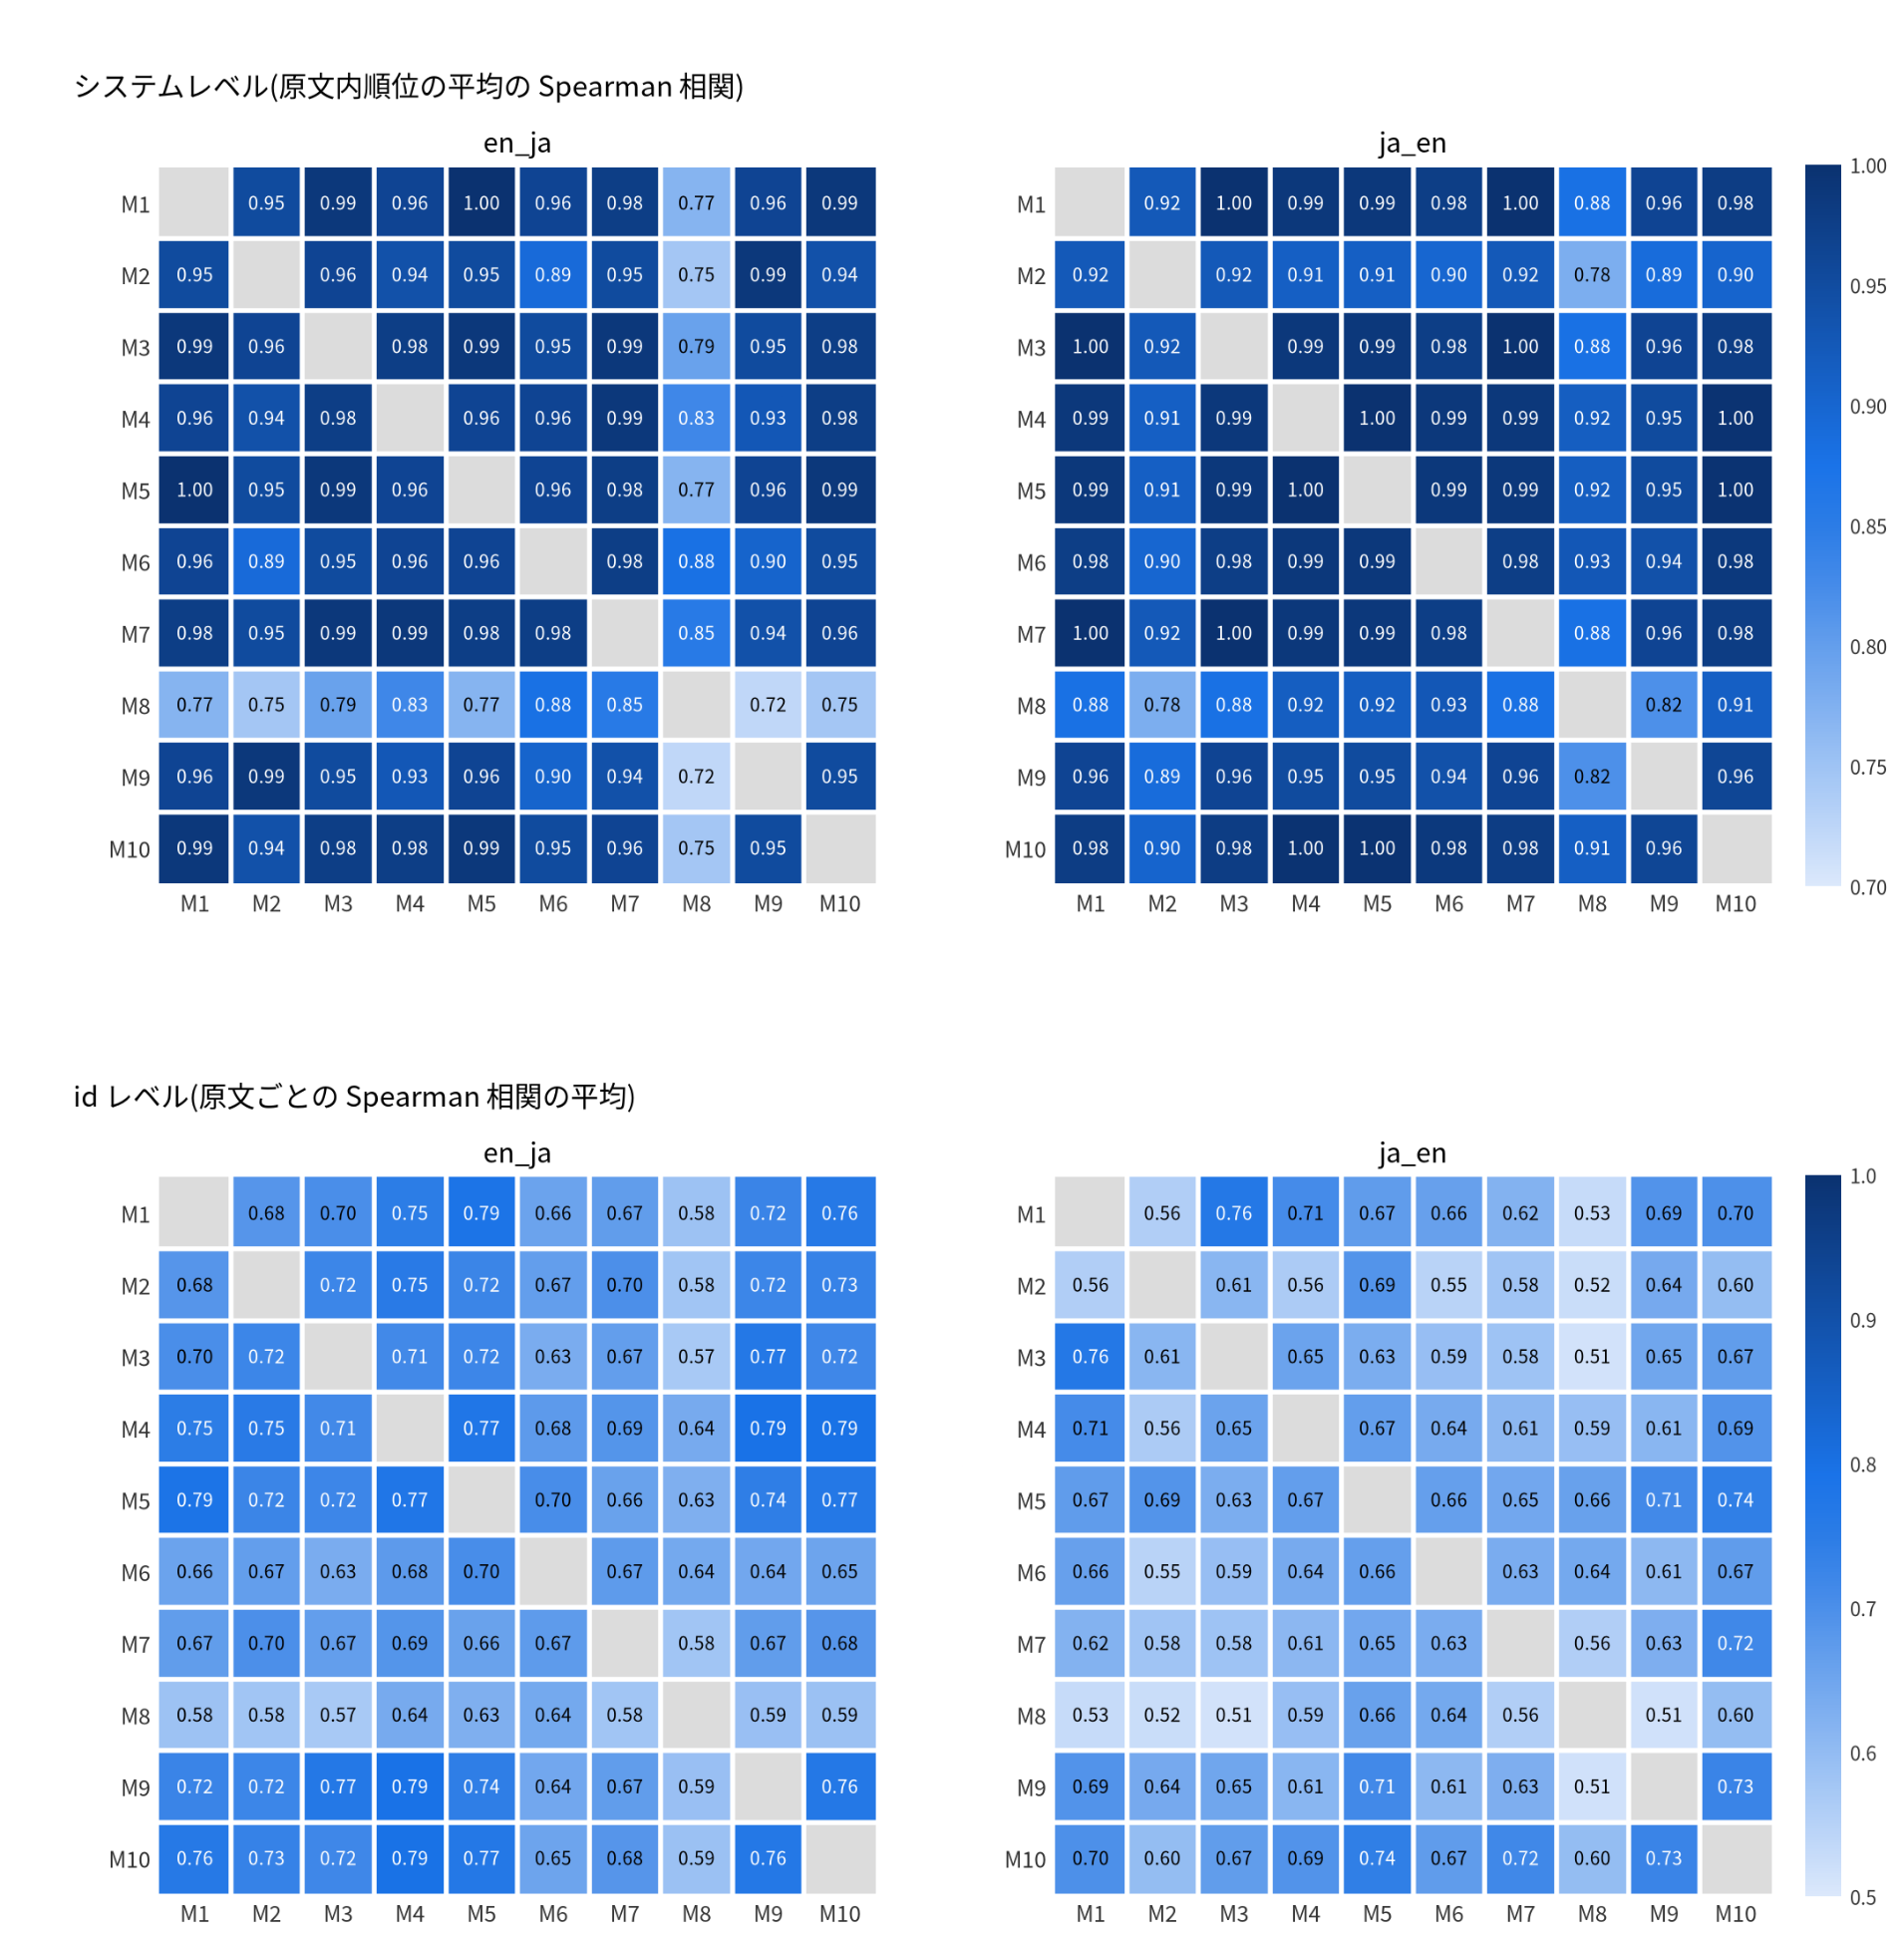
図1 A群を評価したときの参照訳間の合意度。各セルは、2つの参照訳モデルをそれぞれ用いた評価の一致度(Spearman相関)を示します。対角はマスクし、各方向50件の原文で評価しています。上段はシステムレベル、下段はidレベル、左はen_ja、右はja_enです。
図1によれば、システムレベルでは大半のセルが高い値を示しています。日英・英日のそれぞれ50文をまとめて評価すると、多くの組み合わせで評価結果が概ね一致します。一方、idレベルでは、いずれのペアでも相関が低下します。原文ごとの評価結果は、参照訳の生成に使うモデルによって変わることが分かります。
例外として、M8の参照訳を用いた場合には、システムレベルでも他モデルと異なる評価結果となっています。そこで、以降ではidレベルの相関を向上させる手法と、M8の参照訳を用いた場合に見られる順位の違いについて検討します。
単一モデルの参照訳を増やす
まず、単一モデルが生成する参照訳の件数と評価性能の関係を調べます。図2は、特定のモデルが生成した参照訳を、各原文あたり最大10件用いたときのidレベルの評価性能を示します。k件を使う場合の値は、生成した10件からk件を選ぶすべての組み合わせについて平均しています。
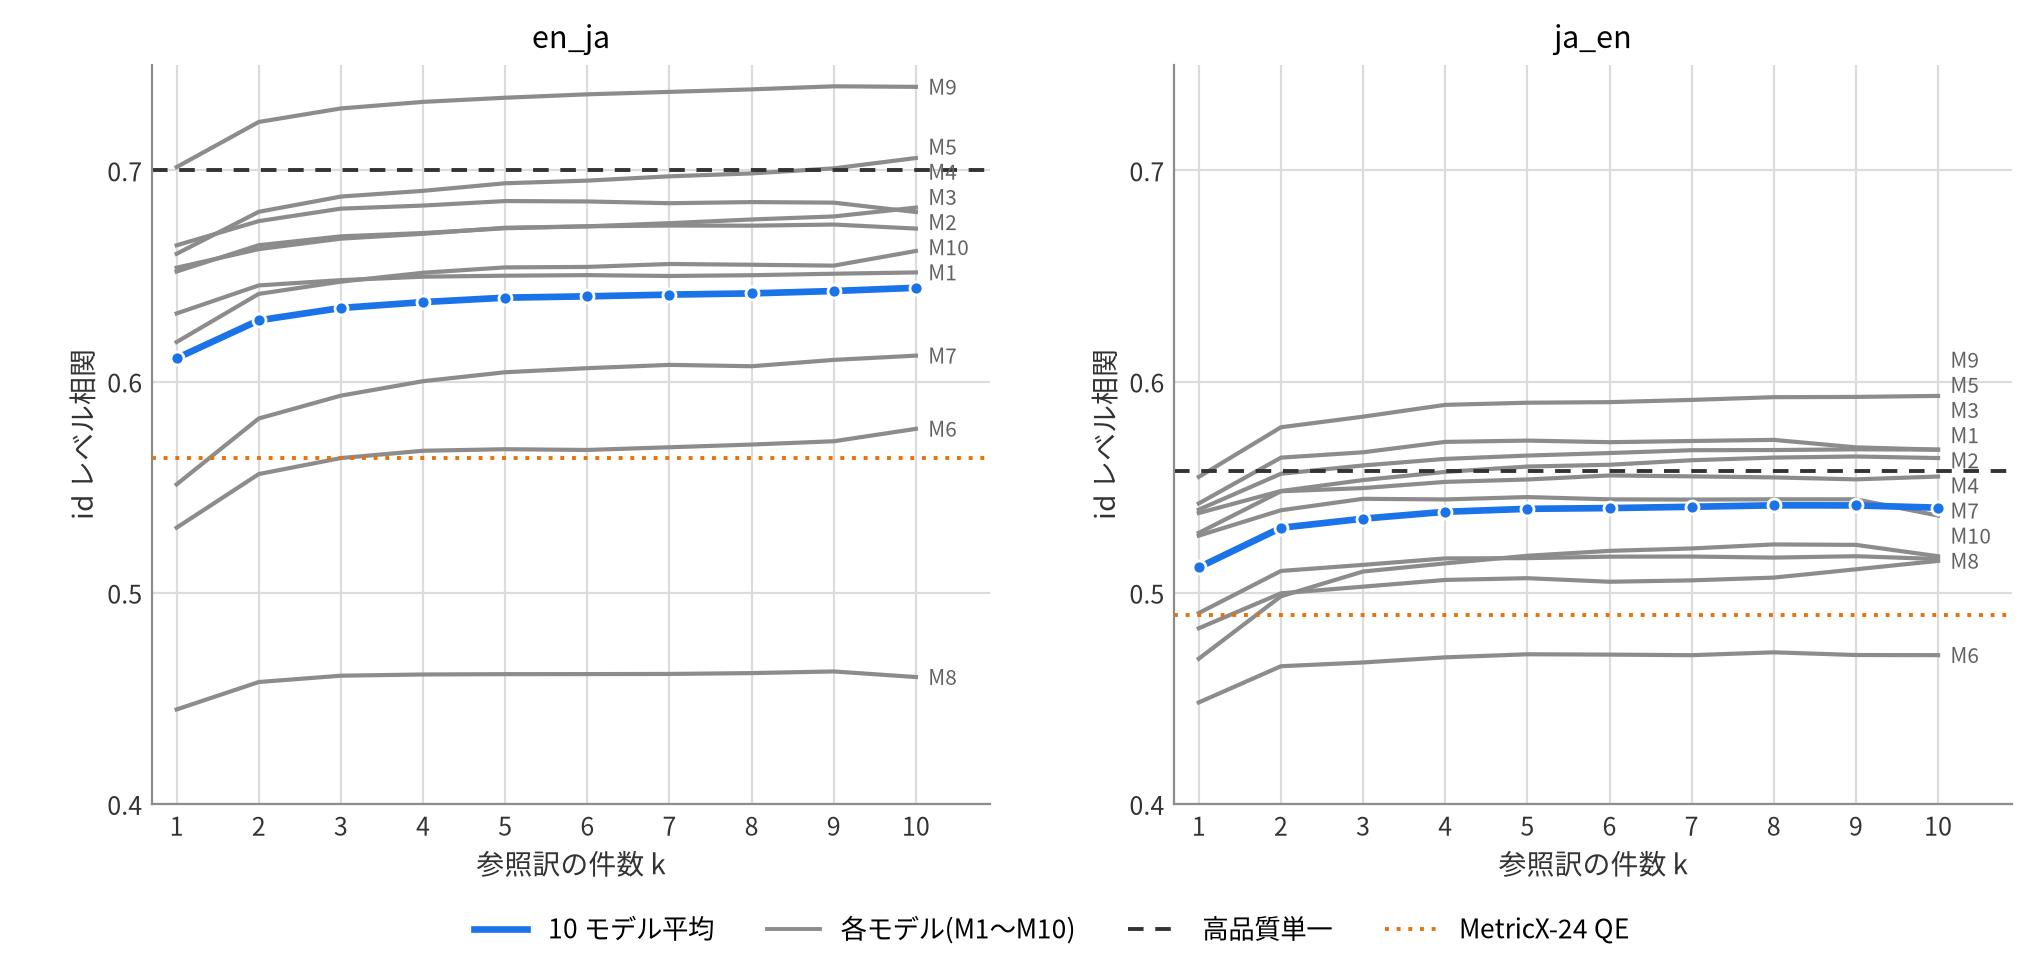
図2 1モデルの参照訳をk件に増やしたときのidレベル相関(A群)。k件の選び方すべてについて平均しています。
図2によると、相関の上昇率はk=1~2 で最も大きく、それ以降の上昇は緩やかです。件数を増やす効果よりも、参照訳の生成に使うモデルによる評価性能の差が大きく、高品質な単一の参照訳を上回るのは一部のモデルに限られます。その数は翻訳方向によって異なります。一方、多くのモデルは参照訳1件の段階でMetricX-24 QEと同等以上の評価性能を示しています。
複数モデルの参照訳を混合する
次に、複数のモデルが生成した参照訳を混合した場合の評価性能を調べます。図3は、参照訳生成に使用した10モデルのなかからいくつかを選び、それらの訳をまとめて参照訳群として用いたときのidレベルの評価性能を示します。図3では各モデルから1件ずつ、選んだモデル数と同じ件数の参照訳を用います。例えば2つのモデルを使用する場合、組み合わせは45通りあります。各組み合わせで得られる評価性能の分布を箱ひげ図で表しています。
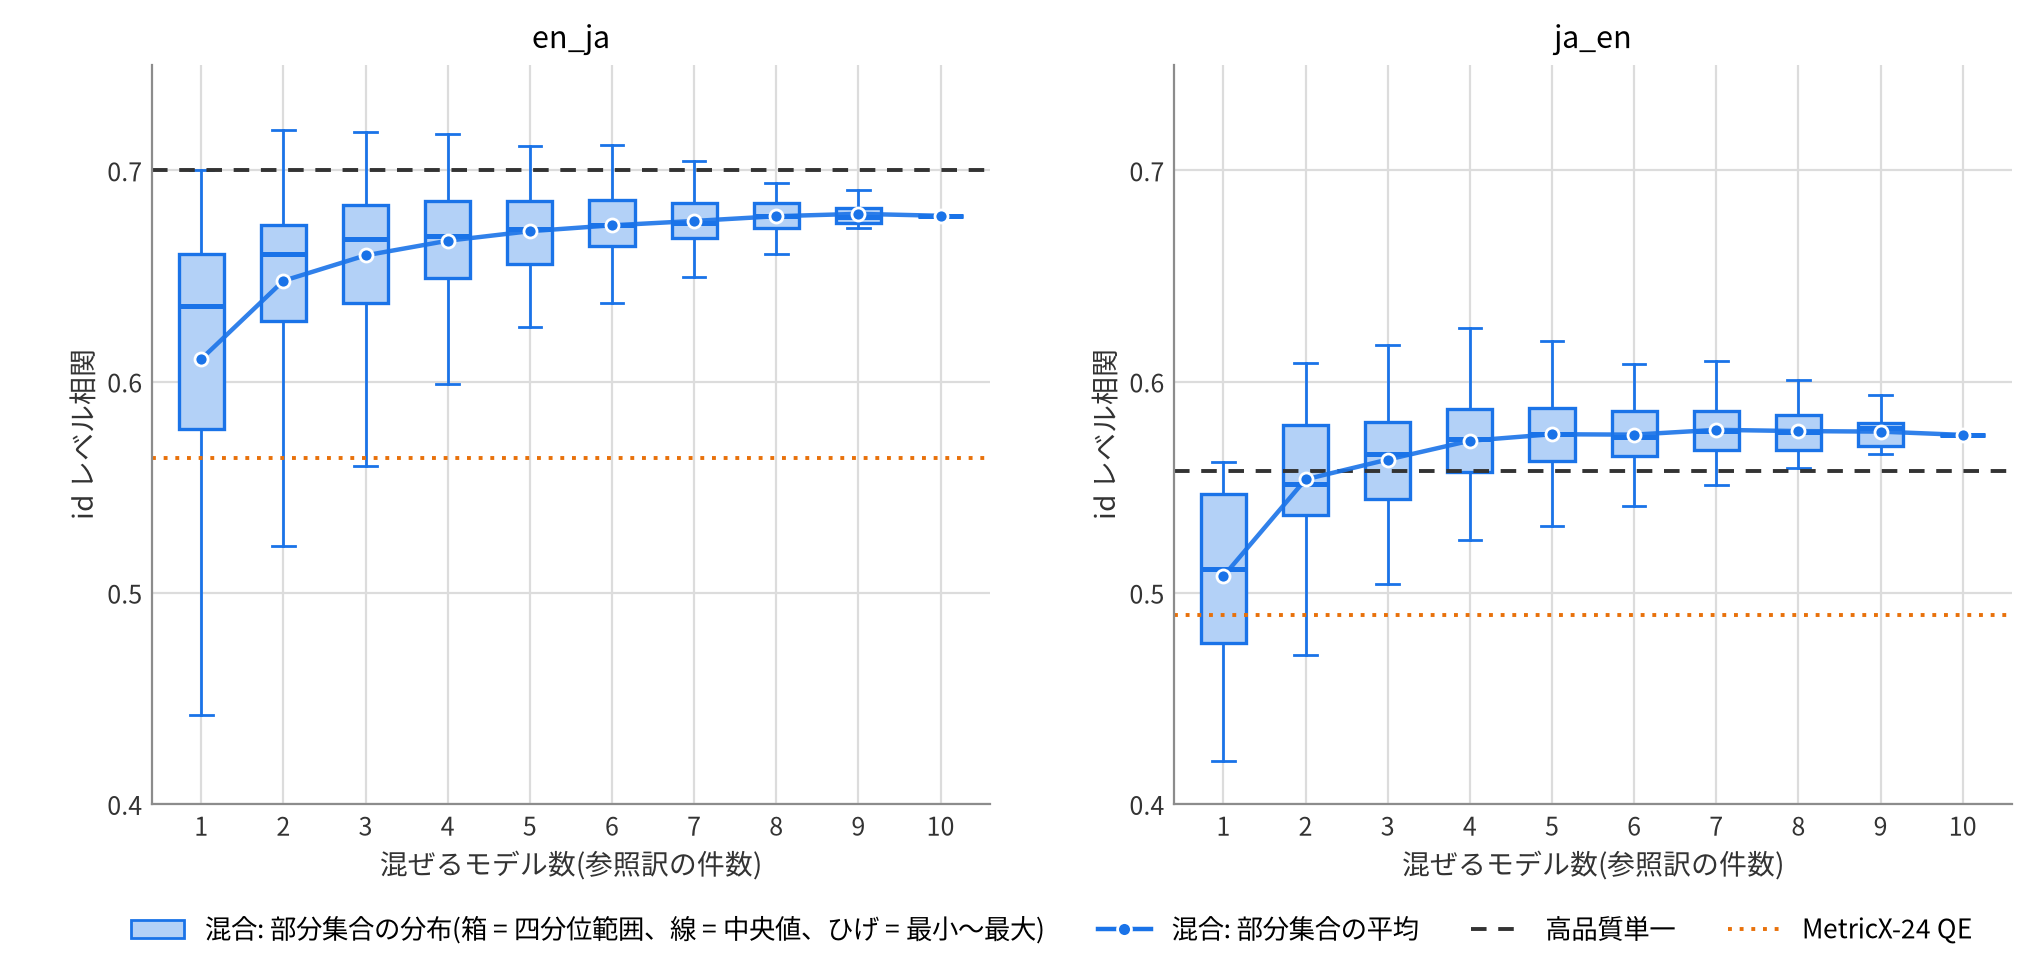
図3 複数モデルの参照訳を混合したときのidレベル相関(A群、箱ひげ図)。
図3では、モデル数が少ないと、組み合わせによって評価性能に大きな差が見られます。平均相関は少数モデルの混合で改善し、その後は概ね飽和しています。10モデル混合では、日英において高品質な単一の参照訳を上回る相関が得られました。ただし、この比較ではモデル数と総参照訳数が同時に増えるため、モデルの多様性だけの効果は分離できません。
続いて、参照訳の作成元による順位変動を比較します。表1は50件全体の順位を示します。Judge基準では英日6位・日英5位のA6は、M8の参照訳1件だけを用いると両方向とも1位になります。10モデルから1件ずつ混合すると英日5位・日英3位となり、この例ではJudge基準との差が縮まります。
一方、Judge基準で両方向とも1位のA1は、M2の参照訳1件では英日2位・日英3位ですが、10モデルから1件ずつ混合すると英日4位・日英6位へ下がります。この例では、混合によりJudge基準との差が広がっています。
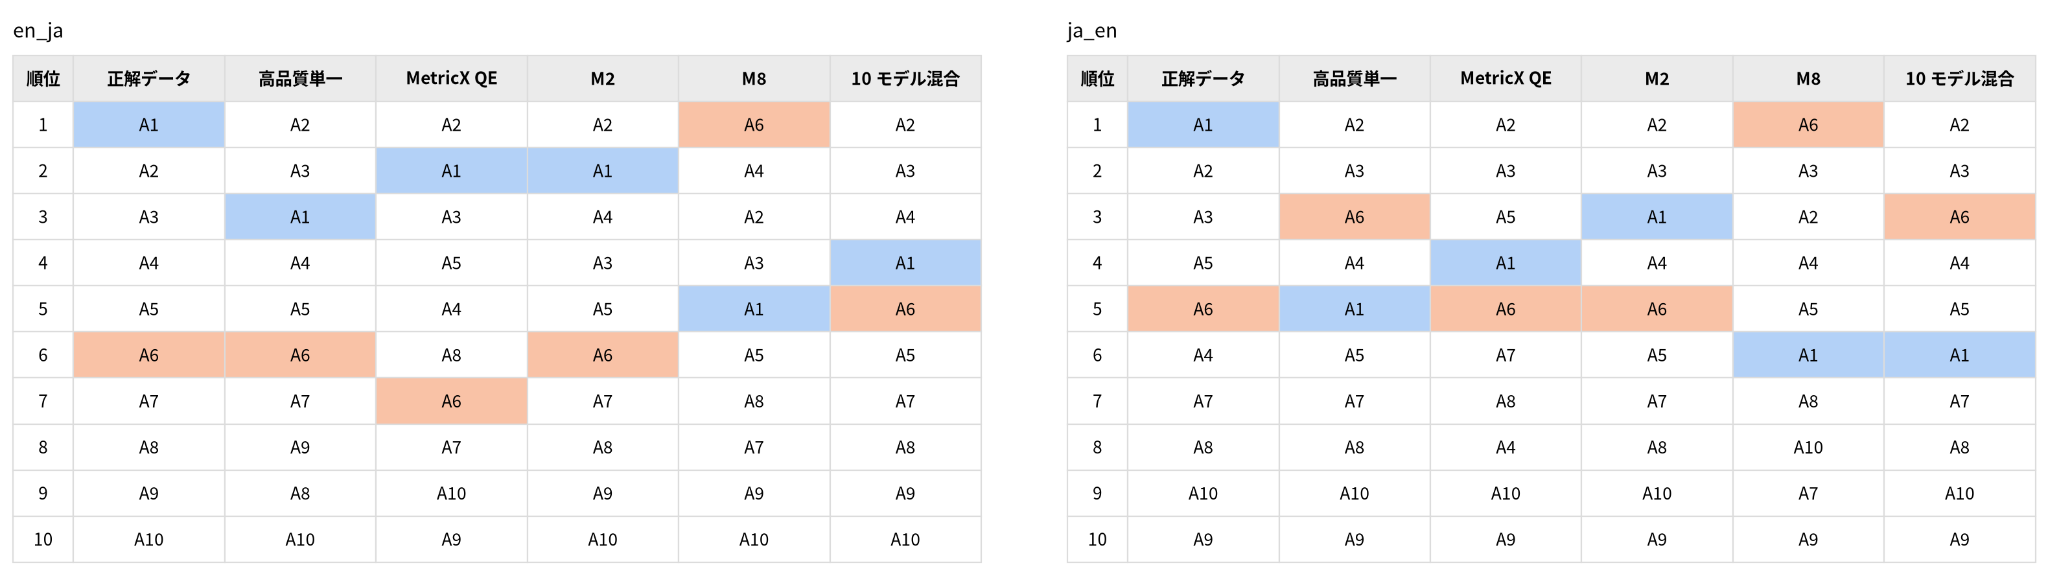
表1 A群の順位:正解データ、高品質単一、MetricX-24 QE、M2の参照訳1件、M8の参照訳1件、10モデル混合。
A1~A10はA群のシステムです。en_jaの正解データの順位で番号を付け、両方向で同じラベルを用いています。M8とM2は、それぞれのモデルの参照訳1件を単独で用いた順位です。MetricX QEは、参照訳を用いないMetricX-24 QEによる順位です。10モデル混合は、10モデルの参照訳を1件ずつ(M2、M8を含む)合わせて用いた順位です。
参照訳の混合は、すべての被評価システムについてJudge基準との一致を改善するわけではありません。参照訳群と異なる表現を用いる訳が相対的に低く評価される可能性はありますが、今回の順位比較だけでは、その原因や実際の翻訳品質との関係までは確定できません。
参照訳生成に使用するモデルの選別
参照訳の生成に使った各モデルの訳文も、LLM-as-a-Judgeで順位付けしました。参照訳の生成に使用した10モデルのうち、上位の3モデルが生成した参照訳だけを用いたときのidレベルの相関を表2に示します。
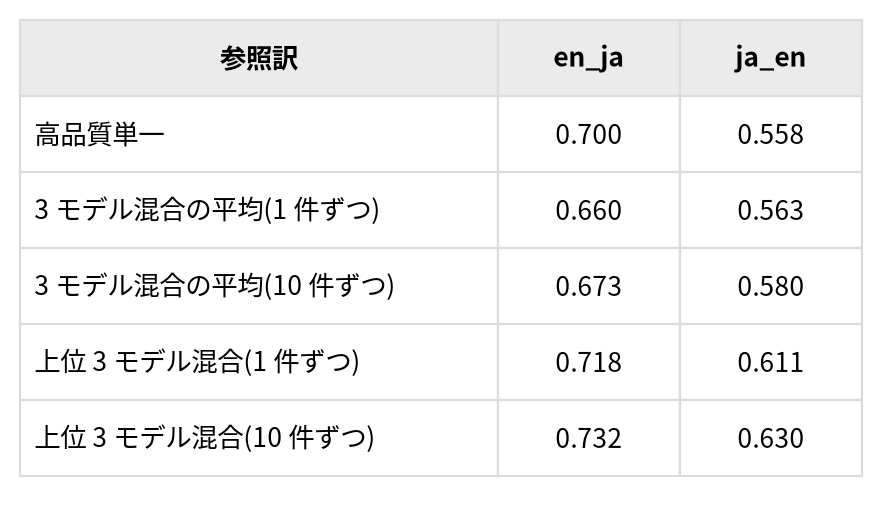
表2 A群のidレベル相関。
表2では、上位3モデルから各10件の参照訳を用いた条件で、相関は英日0.732・日英0.630となり、高品質な単一の参照訳の0.700・0.558を上回っています。同じモデル数・参照訳数(3モデル・各10件)で比べると、選別しない3モデル混合の平均は英日0.673・日英0.580でした。
これは本データとJudge基準における点推定の比較です。選別にもLLM-as-a-Judgeを用いるため、この相関向上を人手評価や別のJudgeに対する改善とみなすことはできません。選別用と評価用のデータやJudgeを変えた場合については、別途検証が必要です。
まとめ
本実験では、10個の事後学習済みLLMで生成した参照訳群とcharsimを組み合わせ、表層マッチング型の翻訳品質評価指標を検討しました。得られた知見は以下の通りです。
- 単一モデルが生成する参照訳を増やした場合、相関の上昇は最初の数件でほぼ飽和し、件数を増やす効果よりも、どのモデルの参照訳を用いるかによる差の方が大きくなりました。
- 複数モデルから1件ずつ参照訳を混合した場合、少数モデルの混合で平均相関が改善し、その後は概ね飽和しました。10モデルの混合では、日英において高品質な単一の参照訳を上回る相関が得られました。
- 参照訳の作成元によって順位が変わりました。混合によってA6の順位はJudge基準に近づく一方、A1の順位は基準から離れており、混合が常に改善につながるわけではありません。
- 参照訳生成モデル自体を LLM-as-a-Judge で順位付けし、上位モデルの参照訳のみを混合して用いた場合、英日・日英ともに高品質な単一の参照訳を上回る相関が得られました。この結果は本データとJudge基準に限ったもので、選別と評価の独立性や別の評価基準での改善は未確認です。参照訳群を選別して固定した後のcharsimによる評価は、文字列比較のみで行えます。
参考文献
[1]Juraj Juraska, Daniel Deutsch, Mara Finkelstein, and Markus Freitag. MetricX-24: The Google Submission to the WMT 2024 Metrics Shared Task. In Proceedings of the Ninth Conference on Machine Translation, pp. 492–504, 2024.
[2] 今城 健太郎, 平野 正徳. 高精度翻訳モデルのための自動評価手法の検討. 言語処理学会 第32回年次大会 発表論文集, pp. 3623–3628, 2026.
[3] 今城 健太郎. charsim:調整に頼らない文字n-gram類似度. いもす研 (imos laboratory), 2026.